STGYの主要クエリ分析
本記事では、STGYの運用上でデータベースに発行されるクエリについて分析する。SQLの具体例を示し、その計算量を解析し、実際の実行計画を見て確認する。
この精査で修正対象とするのは、元のSQLが意図した漸近計算量をSQLの形で保証していない箇所と、ページング結果を欠落させる箇所だけである。特定の検証データで実行時間やバッファ参照数を小さくするだけの書き換えは採用しない。
以下の実行計画は、npm run reset-data-volume-testで作成した検証用データベースを対象にする。make-volume-test.pyは、既存の初期データに加えて、測定用ユーザ1人とダミーユーザ30000人を再現可能なIDと時刻で投入する。ユーザ活動は、投稿0件が12000人、1件が12000人、3件が4500人、10件が1350人、50件が150人というロングテールにする。さらに、長期利用する多投稿ユーザを模したuser00001のルート投稿20000件と、バズった投稿を模したuser00002から1番目のベンチマーク投稿への返信15000件を加え、測定用投稿は合計81502件になる。既存の初期投稿が15件の状態ではpostsの総件数は81517件になる。
フォロー関係も全員相互フォローにはせず、通常ユーザは人気アカウント4人と近接するユーザ8人を決定的にフォローする。測定用ユーザuser00000は5000人をフォローし、20000人からフォローされる高次数ユーザとする。これにより、多数の低次数ユーザ、数百から数千のフォロワーを持つ人気ユーザ、突出した高次数ユーザが同居する分布になる。1番目のベンチマーク投稿には20000件のイイネを付け、測定用ユーザは自分のフォロイーのうち投稿を持つユーザの最新投稿をイイネする。AIユーザはダミーユーザの5人に1人、計6000人とする。検索索引更新キューにはユーザタスク30000件と投稿タスク1000件を投入し、一方の種別が前方に偏って滞留した状態も再現する。イベントログ1000件と、測定用ユーザの未読15000件・既読15000件の通知も投入する。
最後にPostgreSQLのANALYZEを実行するので、本記事のSQLはその直後に実行できる。スクリプトは、各比較で使うカーソルIDと実際の件数も表示する。測定用ユーザのIDは1853070350746583040で、ニックネームはuser00000である。短時間のOLTPクエリにJITコンパイル時間が混入する可能性がある測定では、セッションでSET jit = offを指定する。
最も単純な例
全ての投稿の中から最新20件を取り出す処理を考える。以下のクエリは実際には使われてないが、説明のための単純化したものを紹介する。デフォルトでは返信以外の投稿を一覧するため、reply_toがNULLであるという条件をつける。
SELECT
  p.id, p.owned_by, p.reply_to,
  p.allow_likes, p.allow_replies, p.updated_at
FROM posts p
WHERE p.reply_to IS NULL
ORDER BY p.id DESC OFFSET 0 LIMIT 20;
postsテーブルには、reply_toがNULLのレコードだけを対象としたIDの部分インデックスが設けられているため、そのインデックスを引くだけで処理が完了する。全ての投稿数をPと置くと、探索開始位置を求める計算量はO(log(P))で、そこから20件を読む部分は定数時間で済む。これは、Pが莫大になっても処理量が全件数に比例しないことを意味している。
現行のスキーマとデータで実行計画を確認するには、以下を実行する。実行時間や行数はデータ件数、統計情報、キャッシュ状態によって変わるため、実行後の出力を直後の結果欄へ記録する。
EXPLAIN (ANALYZE, BUFFERS)
SELECT
  p.id, p.owned_by, p.reply_to,
  p.allow_likes, p.allow_replies, p.updated_at
FROM posts p
WHERE p.reply_to IS NULL
ORDER BY p.id DESC OFFSET 0 LIMIT 20;
 Limit  (cost=0.29..2.11 rows=20 width=34) (actual time=0.035..0.044 rows=20 loops=1)
   Buffers: shared hit=3
   ->  Index Scan Backward using idx_posts_root_id on posts p  (cost=0.29..5671.22 rows=62475 width=34) (actual time=0.033..0.040 rows=20 loops=1)
         Buffers: shared hit=3
 Planning Time: 0.201 ms
Execution Time: 0.091 ms実測ではidx_posts_root_idを逆方向へ走査し、20件を得た時点で停止した。追加のSortはなく、参照バッファは3ページ、実行時間は0.091msだった。返却件数が20件に固定されている限り、投稿総数に比例した走査は発生していない。
listPosts
実運用上は、各投稿の著者のユーザIDを名前に解決したり、各投稿につけられたタグ情報やカウンタを結果に含めるために、別のテーブルをJOINすることになる。それを実装しているのが、バックエンドのpostsService.listPostsメソッドだ。reply_toがNULLで、focusUserIdを指定しない場合のクエリは以下のものになる。
SELECT
  p.id, p.owned_by, p.reply_to, p.published_at, p.updated_at,
  p.snippet, p.locale, p.allow_likes, p.allow_replies,
  id_to_timestamp(p.id) AS created_at,
  u.nickname AS owner_nickname,
  u.locale AS owner_locale,
  pp.owned_by AS reply_to_owner_id,
  pu.nickname AS reply_to_owner_nickname,
  COALESCE(pc.reply_count, 0) AS count_replies,
  COALESCE(pc.like_count, 0) AS count_likes,
  ARRAY(SELECT pt2.name FROM post_tags pt2
    WHERE pt2.post_id = p.id ORDER BY pt2.name) AS tags
FROM posts p
JOIN users u ON p.owned_by = u.id
LEFT JOIN posts pp ON p.reply_to = pp.id
LEFT JOIN users pu ON pp.owned_by = pu.id
LEFT JOIN post_counts pc ON pc.post_id = p.id
WHERE p.reply_to IS NULL
ORDER BY p.id DESC OFFSET 0 LIMIT 20;
最も単純な例と同様に、まず投稿IDの部分インデックスで返却対象を絞り、その20件に対してusers、posts、post_counts、post_tagsを参照して属性を肉付けする。focusUserIdが指定された場合には、投稿者がそのユーザをブロックしているかを判定する列も加わる。また、一覧を取得した後に、返却対象の投稿IDに限定して、そのユーザがイイネまたは返信をしているかを別の2クエリでまとめて調べる。
これの計算量を考えよう。全ユーザ数をUと置き、全投稿数をPと置く。まず、該当の投稿のリストを得るのに、インデックスが利けばO(log(P))+O(20)の計算量がかかる。20は定数なので、O(log(P))と表せる。そして、ヒットした20件の各々に対し、カウンタ、タグ、ユーザ名を解決する。各結合先で主キーや複合主キーのインデックスが利けば、20件は定数なので、全体の支配項はO(log(P))またはO(log(U))である。UはPよりも十分に少ないと仮定すると、全体の支配項はO(log(P))ということになる。
現行のクエリを確認するには、以下を実行する。
EXPLAIN (ANALYZE, BUFFERS)
SELECT
  p.id, p.owned_by, p.reply_to, p.published_at, p.updated_at,
  p.snippet, p.locale, p.allow_likes, p.allow_replies,
  id_to_timestamp(p.id) AS created_at,
  u.nickname AS owner_nickname,
  u.locale AS owner_locale,
  pp.owned_by AS reply_to_owner_id,
  pu.nickname AS reply_to_owner_nickname,
  COALESCE(pc.reply_count, 0) AS count_replies,
  COALESCE(pc.like_count, 0) AS count_likes,
  ARRAY(SELECT pt2.name FROM post_tags pt2
    WHERE pt2.post_id = p.id ORDER BY pt2.name) AS tags
FROM posts p
JOIN users u ON p.owned_by = u.id
LEFT JOIN posts pp ON p.reply_to = pp.id
LEFT JOIN users pu ON pp.owned_by = pu.id
LEFT JOIN post_counts pc ON pc.post_id = p.id
WHERE p.reply_to IS NULL
ORDER BY p.id DESC OFFSET 0 LIMIT 20;
Limit (cost=1.33..130.29 rows=20 width=172) (actual time=0.367..0.651 rows=20 loops=1)
Buffers: shared hit=88
-> Nested Loop Left Join (cost=1.33..402825.07 rows=62475 width=172) (actual time=0.364..0.644 rows=20 loops=1)
Buffers: shared hit=88
-> Nested Loop Left Join (cost=1.19..17664.18 rows=62475 width=124) (actual time=0.076..0.131 rows=20 loops=1)
Buffers: shared hit=6
-> Nested Loop Left Join (cost=0.89..12497.75 rows=62475 width=115) (actual time=0.070..0.111 rows=20 loops=1)
Buffers: shared hit=6
-> Nested Loop (cost=0.59..10934.67 rows=62475 width=107) (actual time=0.060..0.086 rows=20 loops=1)
Buffers: shared hit=6
-> Index Scan Backward using idx_posts_root_id on posts p (cost=0.29..5671.22 rows=62475 width=92) (actual time=0.031..0.036 rows=20 loops=1)
Buffers: shared hit=3
-> Memoize (cost=0.30..0.35 rows=1 width=23) (actual time=0.002..0.002 rows=1 loops=20)
Cache Key: p.owned_by
Cache Mode: logical
Hits: 19 Misses: 1 Evictions: 0 Overflows: 0 Memory Usage: 1kB
Buffers: shared hit=3
-> Index Scan using users_pkey on users u (cost=0.29..0.34 rows=1 width=23) (actual time=0.017..0.017 rows=1 loops=1)
Index Cond: (id = p.owned_by)
Buffers: shared hit=3
-> Memoize (cost=0.30..0.41 rows=1 width=16) (actual time=0.001..0.001 rows=0 loops=20)
Cache Key: p.reply_to
Cache Mode: logical
Hits: 19 Misses: 1 Evictions: 0 Overflows: 0 Memory Usage: 1kB
-> Index Scan using posts_pkey on posts pp (cost=0.29..0.40 rows=1 width=16) (actual time=0.007..0.007 rows=0 loops=1)
Index Cond: (id = p.reply_to)
-> Memoize (cost=0.30..0.34 rows=1 width=17) (actual time=0.000..0.000 rows=0 loops=20)
Cache Key: pp.owned_by
Cache Mode: logical
Hits: 19 Misses: 1 Evictions: 0 Overflows: 0 Memory Usage: 1kB
-> Index Scan using users_pkey on users pu (cost=0.29..0.33 rows=1 width=17) (actual time=0.004..0.004 rows=0 loops=1)
Index Cond: (id = pp.owned_by)
-> Append (cost=0.15..1.36 rows=8 width=16) (actual time=0.005..0.005 rows=0 loops=20)
Buffers: shared hit=21
-> Index Scan using post_counts_p0_pkey on post_counts_p0 pc_1 (cost=0.15..0.17 rows=1 width=16) (actual time=0.004..0.004 rows=0 loops=3)
Index Cond: (post_id = p.id)
Buffers: shared hit=3
-> Index Scan using post_counts_p1_pkey on post_counts_p1 pc_2 (cost=0.15..0.17 rows=1 width=16) (actual time=0.002..0.002 rows=0 loops=4)
Index Cond: (post_id = p.id)
Buffers: shared hit=4
-> Index Scan using post_counts_p2_pkey on post_counts_p2 pc_3 (cost=0.15..0.17 rows=1 width=16) (actual time=0.006..0.006 rows=0 loops=1)
Index Cond: (post_id = p.id)
Buffers: shared hit=1
-> Index Scan using post_counts_p3_pkey on post_counts_p3 pc_4 (cost=0.15..0.17 rows=1 width=16) (actual time=0.004..0.004 rows=0 loops=3)
Index Cond: (post_id = p.id)
Buffers: shared hit=3
-> Index Scan using post_counts_p4_pkey on post_counts_p4 pc_5 (cost=0.15..0.17 rows=1 width=16) (actual time=0.004..0.004 rows=0 loops=3)
Index Cond: (post_id = p.id)
Buffers: shared hit=3
-> Index Scan using post_counts_p5_pkey on post_counts_p5 pc_6 (cost=0.15..0.17 rows=1 width=16) (actual time=0.014..0.014 rows=0 loops=1)
Index Cond: (post_id = p.id)
Buffers: shared hit=1
-> Index Scan using post_counts_p6_pkey on post_counts_p6 pc_7 (cost=0.15..0.17 rows=1 width=16) (never executed)
Index Cond: (post_id = p.id)
-> Index Scan using post_counts_p7_pkey on post_counts_p7 pc_8 (cost=0.15..0.17 rows=1 width=16) (actual time=0.004..0.004 rows=0 loops=5)
Index Cond: (post_id = p.id)
Buffers: shared hit=6
SubPlan 1
-> Index Only Scan using post_tags_pkey on post_tags pt2 (cost=0.42..4.47 rows=3 width=8) (actual time=0.006..0.007 rows=3 loops=20)
Index Cond: (post_id = p.id)
Heap Fetches: 0
Buffers: shared hit=61
Planning:
Buffers: shared hit=716 read=5
Planning Time: 5.362 ms
Execution Time: 1.510 ms実測では、まずidx_posts_root_idから20件だけを取得し、その20件に対してNested Loopで属性を肉付けしている。今回の20件は同じ投稿者に属するため、投稿者のusers_pkey検索はMemoizeにより1回だけ実行され、残り19回はキャッシュヒットした。タグはpost_tags_pkeyを20回引き、いずれもIndex Only ScanでHeap Fetchesは0だった。投稿全体やタグ全体を走査する処理はなく、実行時間は1.510msだった。
focusUserIdが指定された場合に、一覧取得後に実行するイイネ済み判定と返信済み判定の2クエリについても個別に実行計画を確認しておく。サービス層では、一覧で返す最大20件の投稿IDを配列として渡す。以下では、検証用データの既知の投稿IDを具体値として使う。
まず、イイネ済み判定は以下のクエリである。検証用データでは、user00001が1番目のベンチマーク投稿をイイネしている。
SELECT post_id
FROM post_likes
WHERE post_id = ANY(
  ARRAY[
    1855878856704991232,
    1855878856706039808
  ]::bigint[]
)
  AND liked_by = 1853160947712987136;
post_likesの主キーはpost_idとliked_byの複合キーであり、クエリの2条件と一致する。配列中の投稿IDは最大20件という定数なので、それぞれについて複合主キーを引ければ、投稿数やイイネ総数に比例せずに判定できる。現行の実行計画を確認するには、以下を実行する。
EXPLAIN (ANALYZE, BUFFERS)
SELECT post_id
FROM post_likes
WHERE post_id = ANY(
  ARRAY[
    1855878856704991232,
    1855878856706039808
  ]::bigint[]
)
  AND liked_by = 1853160947712987136;
Index Scan using idx_post_likes_liked_by_created_at on post_likes (cost=0.29..8.31 rows=1 width=8) (actual time=0.023..0.024 rows=1 loops=1)
Index Cond: (liked_by = '1853160947712987136'::bigint)
Filter: (post_id = ANY ('{1855878856704991232,1855878856706039808}'::bigint[]))
Buffers: shared hit=3
Planning:
Buffers: shared hit=58
Planning Time: 0.565 ms
Execution Time: 0.049 msこの実行計画では、post_likesの複合主キーではなく、idx_post_likes_liked_by_created_atが選ばれ、liked_byだけがIndex Condに入り、post_idはFilterで判定された。今回のuser00001には対象外を含めてもイイネがほとんどないため、イイネした行を先に1件だけ取得してFilterする方が安いとPostgreSQLが判断したものである。3バッファ、0.049msで終了しており、このデータ分布では合理的な計画である。
一方、イイネ数が多いuser00000について、同じSQL形のまま再測定する。配列には、user00000が実際にイイネしているuser00001の投稿と、比較用の別投稿を指定する。
SET jit = off;

EXPLAIN (ANALYZE, BUFFERS)
SELECT post_id
FROM post_likes
WHERE post_id = ANY(
  ARRAY[
    1854338729246674944,
    1855878856706039808
  ]::bigint[]
)
  AND liked_by = 1853070350746583040;
Index Only Scan using post_likes_pkey on post_likes (cost=0.29..8.60 rows=1 width=8) (actual time=0.098..0.131 rows=1 loops=1)
Index Cond: ((post_id = ANY ('{1854338729246674944,1855878856706039808}'::bigint[])) AND (liked_by = '1853070350746583040'::bigint))
Heap Fetches: 0
Buffers: shared hit=5
Planning Time: 0.267 ms
Execution Time: 0.155 msイイネ数が多いユーザでは、post_likes_pkeyがIndex Only Scanされ、post_idとliked_byの両方がIndex Condに入った。Heap Fetchesは0、参照バッファは5ページ、実行時間は0.155msだった。PostgreSQLは、イイネ数が少ないユーザではliked_by側から少数行を読む計画を選び、イイネ数が多いユーザでは最大20個の投稿IDについて複合主キーを引く計画を選んでいる。したがって、このSQLはデータ分布に応じて適切な索引を使い分けており、一覧1ページの候補数Kが最大20件に固定される限り、イイネ済み判定が全イイネ件数に比例する計画へ固定される問題は確認されなかった。SQLやインデックスの追加変更は不要である。
返信済み判定は以下のクエリである。検証用データでは、user00001が20000件の投稿を所有する一方で、user00002が1番目のベンチマーク投稿へ15000件返信する。以下の条件に一致する投稿は0件だが、reply_toだけ、またはowned_byだけで候補を得ると、reply_toだけなら15000件、owned_byだけなら20000件を候補として調べることになる。
SELECT reply_to
FROM posts
WHERE reply_to = ANY(
  ARRAY[
    1855878856704991232,
    1855878856706039808
  ]::bigint[]
)
  AND owned_by = 1853160947712987136;
この処理のために、postsにはreply_toとowned_byの複合インデックスを設ける。
CREATE INDEX idx_posts_reply_to_owned_by
ON posts(reply_to, owned_by);
現行スキーマで実行計画を確認するには、以下を実行する。
EXPLAIN (ANALYZE, BUFFERS)
SELECT reply_to
FROM posts
WHERE reply_to = ANY(
  ARRAY[
    1855878856704991232,
    1855878856706039808
  ]::bigint[]
)
  AND owned_by = 1853160947712987136;
Index Only Scan using idx_posts_reply_to_owned_by on posts (cost=0.29..141.37 rows=4639 width=8) (actual time=0.197..0.198 rows=0 loops=1)
Index Cond: ((reply_to = ANY ('{1855878856704991232,1855878856706039808}'::bigint[])) AND (owned_by = '1853160947712987136'::bigint))
Heap Fetches: 0
Buffers: shared hit=6 read=1
Planning Time: 0.192 ms
Execution Time: 0.219 ms実測ではreply_toとowned_byの両方がidx_posts_reply_to_owned_byのIndex Condに入り、Index Only Scan、Heap Fetches 0で終了した。参照バッファは7ページ、実行時間は0.219msだった。対象ユーザの20000投稿、または対象投稿についた15000返信を片側の条件だけで列挙してからFilterで捨てる処理は発生していない。
複合インデックスがない場合との差を同じ検証データで確認するには、以下を実行する。DROP INDEXはトランザクション内で行い、最後にROLLBACKするので、検証後にはインデックスが復元される。
BEGIN;

DROP INDEX idx_posts_reply_to_owned_by;

EXPLAIN (ANALYZE, BUFFERS)
SELECT reply_to
FROM posts
WHERE reply_to = ANY(
  ARRAY[
    1855878856704991232,
    1855878856706039808
  ]::bigint[]
)
  AND owned_by = 1853160947712987136;

ROLLBACK;
Bitmap Heap Scan on posts (cost=424.91..1950.70 rows=4666 width=8) (actual time=3.090..3.092 rows=0 loops=1)
Recheck Cond: (reply_to = ANY ('{1855878856704991232,1855878856706039808}'::bigint[]))
Filter: (owned_by = '1853160947712987136'::bigint)
Rows Removed by Filter: 19071
Heap Blocks: exact=741
Buffers: shared hit=831
-> Bitmap Index Scan on idx_posts_reply_to_id (cost=0.00..423.74 rows=19053 width=0) (actual time=0.737..0.738 rows=19071 loops=1)
Index Cond: (reply_to = ANY ('{1855878856704991232,1855878856706039808}'::bigint[]))
Buffers: shared hit=90
Planning:
Buffers: shared hit=181
Planning Time: 0.671 ms
Execution Time: 3.145 ms実測では、複合インデックスを外すとidx_posts_reply_to_idから19071件を取得し、owned_byをFilterで判定して19071件すべてを除外した。741ヒープブロック、831バッファを参照し、実行時間は3.145msだった。複合インデックスありでは両条件がIndex Condに入り、7バッファ、0.219msで終了している。これは単なる定数倍ではなく、片側条件に一致する返信数に比例する走査を避けるためにidx_posts_reply_to_owned_byが必要であることを確認する結果である。
listPostsByFollowees
STGYのSNSとしての典型的なビューは、「自分がフォローしているユーザの投稿の一覧」を見ることである。これがログイン直後のデフォルトのビューでもある。このクエリが効率的に処理できるかどうかがSNSの性能を決めると言って良い。
基本戦略としては、表示件数が20件という定数であることを利用して計算量の削減を図る。フロントエンドのデフォルトでは自分を含む最新アクティブユーザを最大20人選び、その各々から最新3件を取り出すことで、候補を最大60件に限定する。実際のクエリを具体値で表すと以下のようになる。返信を含める場合の例である。
WITH
all_followers AS (
  SELECT followee_id
  FROM user_follows
  WHERE follower_id = 1853070350746583040
  UNION
  SELECT 1853070350746583040
),
active_followers AS (
  SELECT af.followee_id AS owned_by, latest_post.id AS last_id
  FROM all_followers af
  JOIN LATERAL (
    SELECT p2.id
    FROM posts p2
    WHERE p2.owned_by = af.followee_id
    ORDER BY p2.id DESC
    LIMIT 1
  ) AS latest_post ON TRUE
),
top_followees AS (
  SELECT owned_by
  FROM active_followers
  ORDER BY last_id DESC
  LIMIT 20
),
candidates AS (
  SELECT pid.id
  FROM top_followees tf
  JOIN LATERAL (
    SELECT p2.id
    FROM posts p2
    WHERE p2.owned_by = tf.owned_by
    ORDER BY p2.id DESC
    LIMIT 3
  ) AS pid ON TRUE
),
top_posts AS (
  SELECT id
  FROM candidates
  ORDER BY id DESC
  OFFSET 0
  LIMIT 20
)
SELECT
  p.id, p.owned_by, p.reply_to, p.published_at, p.updated_at,
  p.snippet, p.locale, p.allow_likes, p.allow_replies,
  id_to_timestamp(p.id) AS created_at,
  u.nickname AS owner_nickname,
  u.locale AS owner_locale,
  pp.owned_by AS reply_to_owner_id,
  pu.nickname AS reply_to_owner_nickname,
  COALESCE(pc.reply_count, 0) AS count_replies,
  COALESCE(pc.like_count, 0) AS count_likes,
  ARRAY(SELECT pt2.name FROM post_tags pt2
    WHERE pt2.post_id = p.id ORDER BY pt2.name) AS tags
FROM top_posts t
JOIN posts p ON p.id = t.id
JOIN users u ON p.owned_by = u.id
LEFT JOIN posts pp ON p.reply_to = pp.id
LEFT JOIN users pu ON pp.owned_by = pu.id
LEFT JOIN post_counts pc ON pc.post_id = p.id
ORDER BY t.id DESC;
クエリが込み入っているので、部分ごとに解説しよう。
- フォローしているユーザのIDと自分自身をall_followersというビューとして作る。フォローしているユーザのIDへ自分自身をUNIONで加えた集合を作る。
- all_followersの各ユーザについて、
(owned_by, id)インデックスを末尾から引き、LIMIT 1で最新投稿だけを取得したactive_followersというビューを作る。 - active_followersを最新投稿IDで並べ、最も最近に投稿したトップ20人のユーザIDをtop_followeesに残す。
- top_followeesの各ユーザIDにJOIN LATERALして、各ユーザの最新投稿IDを3件ずつ取り出したcandidatesというビューを作る。
- candidatesの最大60件の投稿IDを並べ、最新20件に絞ったtop_postsというビューを作る。
- top_postsの各々のIDに対して、listPostsと同様に各種属性を肉付けする。
返信を表示しない場合には、active_followersとcandidatesの両方へp2.reply_to IS NULLが加わる。APIでは一人あたりの取得件数をlimitPerUserで指定でき、フロントエンドのデフォルトが3である。focusUserIdが指定された場合のブロック判定と、取得後のイイネ・返信状態の追加もlistPostsと同じである。
以前のactive_followersは、対象フォロイーの投稿をまとめて読み、DISTINCT ON (owned_by)で各ユーザの最新投稿を選んでいた。そのSQLでは結合順と走査範囲をプランナに任せるため、選択されたフォロイーの投稿数が多いと、その投稿集合に比例して読む計画を取り得る。現行SQLはall_followersの各IDを外側に置き、LIMIT 1を持つLATERAL副問い合わせで索引検索を1回ずつ行うため、意図したフォロイー数Fに比例する計算量をSQLの形で保証する。
これの計算量を考えよう。全投稿数をP、フォローしているユーザ数をFと置く。各フォロイーについて(owned_by, id)インデックスから最新投稿を1件取得する処理の支配項はO(F・log(P))である。トップ20人を選ぶ処理はF件からのtop-N選択なのでO(F・log(20))、すなわちO(F)と見なせる。その後の最大60投稿と最終20投稿の処理量は定数である。したがって全体の支配項はO(F・log(P))になる。投稿総数Pを一括走査しない一方で、処理量がFに比例する点は残る。
現行のクエリを確認するには、以下を実行する。短時間のOLTPクエリへJITコンパイル時間が混入するのを避けるため、この測定ではJITを無効にした。
SET jit = off;

EXPLAIN (ANALYZE, BUFFERS)
WITH
all_followers AS (
  SELECT followee_id
  FROM user_follows
  WHERE follower_id = 1853070350746583040
  UNION
  SELECT 1853070350746583040
),
active_followers AS (
  SELECT af.followee_id AS owned_by, latest_post.id AS last_id
  FROM all_followers af
  JOIN LATERAL (
    SELECT p2.id
    FROM posts p2
    WHERE p2.owned_by = af.followee_id
    ORDER BY p2.id DESC
    LIMIT 1
  ) AS latest_post ON TRUE
),
top_followees AS (
  SELECT owned_by
  FROM active_followers
  ORDER BY last_id DESC
  LIMIT 20
),
candidates AS (
  SELECT pid.id
  FROM top_followees tf
  JOIN LATERAL (
    SELECT p2.id
    FROM posts p2
    WHERE p2.owned_by = tf.owned_by
    ORDER BY p2.id DESC
    LIMIT 3
  ) AS pid ON TRUE
),
top_posts AS (
  SELECT id
  FROM candidates
  ORDER BY id DESC
  OFFSET 0
  LIMIT 20
)
SELECT
  p.id, p.owned_by, p.reply_to, p.published_at, p.updated_at,
  p.snippet, p.locale, p.allow_likes, p.allow_replies,
  id_to_timestamp(p.id) AS created_at,
  u.nickname AS owner_nickname,
  u.locale AS owner_locale,
  pp.owned_by AS reply_to_owner_id,
  pu.nickname AS reply_to_owner_nickname,
  COALESCE(pc.reply_count, 0) AS count_replies,
  COALESCE(pc.like_count, 0) AS count_likes,
  ARRAY(SELECT pt2.name FROM post_tags pt2
    WHERE pt2.post_id = p.id ORDER BY pt2.name) AS tags
FROM top_posts t
JOIN posts p ON p.id = t.id
JOIN users u ON p.owned_by = u.id
LEFT JOIN posts pp ON p.reply_to = pp.id
LEFT JOIN users pu ON pp.owned_by = pu.id
LEFT JOIN post_counts pc ON pc.post_id = p.id
ORDER BY t.id DESC;
Nested Loop Left Join (cost=7099.42..7402.62 rows=20 width=180) (actual time=15.932..16.575 rows=20 loops=1)
Buffers: shared hit=10268 read=22
-> Nested Loop Left Join (cost=7099.27..7279.33 rows=20 width=132) (actual time=15.666..15.851 rows=20 loops=1)
Buffers: shared hit=10180 read=22
-> Nested Loop Left Join (cost=7098.98..7272.64 rows=20 width=123) (actual time=15.662..15.823 rows=20 loops=1)
Buffers: shared hit=10171 read=22
-> Nested Loop (cost=7098.68..7271.04 rows=20 width=115) (actual time=15.648..15.773 rows=20 loops=1)
Buffers: shared hit=10168 read=22
-> Nested Loop (cost=7098.39..7264.35 rows=20 width=100) (actual time=15.630..15.697 rows=20 loops=1)
Buffers: shared hit=10108 read=22
-> Limit (cost=7098.10..7098.15 rows=20 width=8) (actual time=15.619..15.630 rows=20 loops=1)
Buffers: shared hit=10048 read=22
-> Sort (cost=7098.10..7098.25 rows=60 width=8) (actual time=15.618..15.624 rows=20 loops=1)
Sort Key: p2_1.id DESC
Sort Method: top-N heapsort Memory: 25kB
Buffers: shared hit=10048 read=22
-> Nested Loop (cost=7029.05..7096.50 rows=60 width=8) (actual time=15.492..15.561 rows=60 loops=1)
Buffers: shared hit=10045 read=22
-> Limit (cost=7028.75..7028.80 rows=20 width=16) (actual time=15.480..15.486 rows=20 loops=1)
Buffers: shared hit=10004 read=22
-> Sort (cost=7028.75..7041.27 rows=5006 width=16) (actual time=15.479..15.482 rows=20 loops=1)
Sort Key: p2.id DESC
Sort Method: top-N heapsort Memory: 26kB
Buffers: shared hit=10004 read=22
-> Nested Loop (cost=237.86..6895.55 rows=5006 width=16) (actual time=4.469..15.040 rows=2503 loops=1)
Buffers: shared hit=10004 read=22
-> HashAggregate (cost=237.56..287.62 rows=5006 width=8) (actual time=4.448..5.349 rows=5001 loops=1)
Group Key: user_follows.followee_id
Batches: 1 Memory Usage: 465kB
Buffers: shared hit=1 read=22
-> Append (cost=0.42..225.05 rows=5006 width=8) (actual time=0.187..2.586 rows=5001 loops=1)
Buffers: shared hit=1 read=22
-> Index Only Scan using user_follows_pkey on user_follows (cost=0.42..200.01 rows=5005 width=8) (actual time=0.185..1.736 rows=5000 loops=1)
Index Cond: (follower_id = '1853070350746583040'::bigint)
Heap Fetches: 0
Buffers: shared hit=1 read=22
-> Result (cost=0.00..0.01 rows=1 width=8) (actual time=0.002..0.002 rows=1 loops=1)
-> Limit (cost=0.29..1.31 rows=1 width=8) (actual time=0.002..0.002 rows=1 loops=5001)
Buffers: shared hit=10003
-> Index Only Scan Backward using idx_posts_owned_by_id on posts p2 (cost=0.29..8.43 rows=8 width=8) (actual time=0.001..0.001 rows=1 loops=5001)
Index Cond: (owned_by = user_follows.followee_id)
Heap Fetches: 0
Buffers: shared hit=10003
-> Limit (cost=0.29..3.35 rows=3 width=8) (actual time=0.002..0.003 rows=3 loops=20)
Buffers: shared hit=41
-> Index Only Scan Backward using idx_posts_owned_by_id on posts p2_1 (cost=0.29..8.43 rows=8 width=8) (actual time=0.002..0.002 rows=3 loops=20)
Index Cond: (owned_by = user_follows.followee_id)
Heap Fetches: 0
Buffers: shared hit=41
-> Index Scan using posts_pkey on posts p (cost=0.29..8.31 rows=1 width=92) (actual time=0.002..0.002 rows=1 loops=20)
Index Cond: (id = p2_1.id)
Buffers: shared hit=60
-> Index Scan using users_pkey on users u (cost=0.29..0.33 rows=1 width=23) (actual time=0.002..0.002 rows=1 loops=20)
Index Cond: (id = p.owned_by)
Buffers: shared hit=60
-> Memoize (cost=0.30..0.39 rows=1 width=16) (actual time=0.002..0.002 rows=0 loops=20)
Cache Key: p.reply_to
Cache Mode: logical
Hits: 18 Misses: 2 Evictions: 0 Overflows: 0 Memory Usage: 1kB
Buffers: shared hit=3
-> Index Scan using posts_pkey on posts pp (cost=0.29..0.38 rows=1 width=16) (actual time=0.012..0.012 rows=0 loops=2)
Index Cond: (id = p.reply_to)
Buffers: shared hit=3
-> Index Scan using users_pkey on users pu (cost=0.29..0.33 rows=1 width=17) (actual time=0.001..0.001 rows=0 loops=20)
Index Cond: (id = pp.owned_by)
Buffers: shared hit=9
-> Append (cost=0.15..1.36 rows=8 width=16) (actual time=0.012..0.012 rows=0 loops=20)
Buffers: shared hit=27
-> Index Scan using post_counts_p0_pkey on post_counts_p0 pc_1 (cost=0.15..0.17 rows=1 width=16) (actual time=0.022..0.022 rows=0 loops=1)
Index Cond: (post_id = p.id)
Buffers: shared hit=1
-> Index Scan using post_counts_p1_pkey on post_counts_p1 pc_2 (cost=0.15..0.17 rows=1 width=16) (actual time=0.007..0.007 rows=0 loops=5)
Index Cond: (post_id = p.id)
Buffers: shared hit=7
-> Index Scan using post_counts_p2_pkey on post_counts_p2 pc_3 (cost=0.15..0.17 rows=1 width=16) (actual time=0.010..0.010 rows=1 loops=3)
Index Cond: (post_id = p.id)
Buffers: shared hit=5
-> Index Scan using post_counts_p3_pkey on post_counts_p3 pc_4 (cost=0.15..0.17 rows=1 width=16) (actual time=0.017..0.017 rows=0 loops=1)
Index Cond: (post_id = p.id)
Buffers: shared hit=1
-> Index Scan using post_counts_p4_pkey on post_counts_p4 pc_5 (cost=0.15..0.17 rows=1 width=16) (actual time=0.007..0.007 rows=0 loops=4)
Index Cond: (post_id = p.id)
Buffers: shared hit=5
-> Index Scan using post_counts_p5_pkey on post_counts_p5 pc_6 (cost=0.15..0.17 rows=1 width=16) (actual time=0.017..0.017 rows=0 loops=1)
Index Cond: (post_id = p.id)
Buffers: shared hit=1
-> Index Scan using post_counts_p6_pkey on post_counts_p6 pc_7 (cost=0.15..0.17 rows=1 width=16) (actual time=0.008..0.009 rows=0 loops=4)
Index Cond: (post_id = p.id)
Buffers: shared hit=5
-> Index Scan using post_counts_p7_pkey on post_counts_p7 pc_8 (cost=0.15..0.17 rows=1 width=16) (actual time=0.030..0.030 rows=1 loops=1)
Index Cond: (post_id = p.id)
Buffers: shared hit=2
SubPlan 1
-> Index Only Scan using post_tags_pkey on post_tags pt2 (cost=0.42..4.47 rows=3 width=8) (actual time=0.010..0.011 rows=3 loops=20)
Index Cond: (post_id = p.id)
Heap Fetches: 0
Buffers: shared hit=61
Planning:
Buffers: shared hit=785 read=4
Planning Time: 6.977 ms
Execution Time: 17.011 ms実測では、user_follows_pkeyからフォロイー5000人をIndex Only Scanし、自分を加えた5001人を外側に置いた。各ユーザについてidx_posts_owned_by_idを逆方向にLIMIT 1で検索する副問い合わせが5001回実行され、投稿を持つ2503人から最新投稿を1件ずつ得た。投稿81517件を一括走査する処理はない。そこから最新活動ユーザ20人をtop-N heapsortで選び、その20人について同じ索引を20回引いて各3件、合計60件の候補を得た後、最終20件だけに属性を肉付けしている。参照バッファは合計10290ページ、実行時間は17.011msだった。
LATERAL副問い合わせのループ数は投稿総数Pではなくフォロイー数Fに対応しており、意図したO(F・log(P))の走査方向が維持されている。5000フォロイーという高次数ユーザでも約17msで完了したが、重要なのは実行時間そのものではなく、フォロイーが所有する全投稿の走査へ戻っていないことである。
検証途中には、自己IDを加える集合演算をUNION ALLへ変えた版も検討した。しかし、自己フォロー禁止という制約の下で重複が生じないことを利用した定数倍の変更であり、今回の計算量修正には不要なので最終版へ入れていない。フォロイーごとの索引検索はF回行われるため、索引の作業集合がメモリとOSのページキャッシュに収まらない規模ではランダムI/Oの影響を受けるが、それは意図した計算量とは別の容量上の問題である。
BuildSearchSeedForUser
AIユーザの興味を作るBuildSearchSeedForUserでも、フォロイーのうち最近活動したユーザを選ぶ。以前は対象フォロイーの投稿をまとめて読み、DISTINCT ON (owned_by)で各ユーザの最新投稿を選んでいたため、フォロイーが所有する投稿集合の大きさに比例する計画を取り得た。現在はlistPostsByFolloweesと同じ形で、各followee_idについて最新投稿を1件だけ索引検索する。
followees AS (
  SELECT uf.followee_id
  FROM user_follows uf
  WHERE uf.follower_id = $1
),
active_followees AS (
  SELECT f.followee_id AS owned_by, latest_post.id AS last_id
  FROM followees f
  JOIN LATERAL (
    SELECT p2.id
    FROM posts p2
    WHERE p2.owned_by = f.followee_id
    ORDER BY p2.id DESC
    LIMIT 1
  ) AS latest_post ON TRUE
),
top_followees AS (
  SELECT owned_by AS followee_id
  FROM active_followees
  ORDER BY last_id DESC
  LIMIT 25
)フォロイー数をF、投稿数をPとすると、active_followeesの支配項はO(F・log(P))である。その後に選ぶフォロイー数25件と、各フォロイーから読む投稿・イイネ件数には固定上限がある。ここでも必要な修正はDISTINCT ONからフォロイー別のLIMIT 1へ変えることだけであり、フォロイー集合の作り方などは変更していない。
listPostsLikedByUser
自分がイイネした投稿の一覧を得るには、以下のクエリが使われる。現在は投稿と著者だけでなく、ロケール、カウンタ、返信先所有者、タグも返す。
SELECT
  p.id, p.owned_by, p.reply_to, p.published_at, p.updated_at,
  p.snippet, p.locale, p.allow_likes, p.allow_replies,
  id_to_timestamp(p.id) AS created_at,
  u.nickname AS owner_nickname,
  u.locale AS owner_locale,
  pp.owned_by AS reply_to_owner_id,
  pu.nickname AS reply_to_owner_nickname,
  COALESCE(pc.reply_count, 0) AS count_replies,
  COALESCE(pc.like_count, 0) AS count_likes,
  ARRAY(SELECT pt.name FROM post_tags pt
    WHERE pt.post_id = p.id ORDER BY pt.name) AS tags
FROM post_likes pl
JOIN posts p ON pl.post_id = p.id
JOIN users u ON p.owned_by = u.id
LEFT JOIN posts pp ON p.reply_to = pp.id
LEFT JOIN users pu ON pp.owned_by = pu.id
LEFT JOIN post_counts pc ON pc.post_id = p.id
WHERE pl.liked_by = 1853070350746583040
ORDER BY pl.created_at DESC OFFSET 0 LIMIT 20;返信を除外する指定では、p.reply_to IS NULLが追加される。focusUserIdが指定された場合のブロック判定と、取得後のイイネ・返信状態の追加も他の投稿一覧と同じである。liked_byとcreated_atの複合インデックスが利けば、返却対象の投稿IDを時間順に取り出し、その定数件に属性を肉付けできる。
現行のクエリを確認するには、以下を実行する。
EXPLAIN (ANALYZE, BUFFERS)
SELECT
  p.id, p.owned_by, p.reply_to, p.published_at, p.updated_at,
  p.snippet, p.locale, p.allow_likes, p.allow_replies,
  id_to_timestamp(p.id) AS created_at,
  u.nickname AS owner_nickname,
  u.locale AS owner_locale,
  pp.owned_by AS reply_to_owner_id,
  pu.nickname AS reply_to_owner_nickname,
  COALESCE(pc.reply_count, 0) AS count_replies,
  COALESCE(pc.like_count, 0) AS count_likes,
  ARRAY(SELECT pt.name FROM post_tags pt
    WHERE pt.post_id = p.id ORDER BY pt.name) AS tags
FROM post_likes pl
JOIN posts p ON pl.post_id = p.id
JOIN users u ON p.owned_by = u.id
LEFT JOIN posts pp ON p.reply_to = pp.id
LEFT JOIN users pu ON pp.owned_by = pu.id
LEFT JOIN post_counts pc ON pc.post_id = p.id
WHERE pl.liked_by = 1853070350746583040
ORDER BY pl.created_at DESC OFFSET 0 LIMIT 20;
Limit (cost=1.61..178.90 rows=20 width=180) (actual time=0.240..1.178 rows=20 loops=1)
Buffers: shared hit=233
-> Nested Loop Left Join (cost=1.61..22179.66 rows=2502 width=180) (actual time=0.239..1.172 rows=20 loops=1)
Buffers: shared hit=233
-> Nested Loop Left Join (cost=1.47..6756.17 rows=2502 width=132) (actual time=0.112..0.355 rows=20 loops=1)
Buffers: shared hit=132
-> Nested Loop Left Join (cost=1.18..5919.16 rows=2502 width=123) (actual time=0.107..0.326 rows=20 loops=1)
Buffers: shared hit=126
-> Nested Loop (cost=0.88..5855.46 rows=2502 width=115) (actual time=0.098..0.290 rows=20 loops=1)
Buffers: shared hit=123
-> Nested Loop (cost=0.59..5018.45 rows=2502 width=100) (actual time=0.087..0.220 rows=20 loops=1)
Buffers: shared hit=63
-> Index Scan Backward using idx_post_likes_liked_by_created_at on post_likes pl (cost=0.29..608.26 rows=2502 width=16) (actual time=0.058..0.067 rows=20 loops=1)
Index Cond: (liked_by = '1853070350746583040'::bigint)
Buffers: shared hit=3
-> Memoize (cost=0.30..2.67 rows=1 width=92) (actual time=0.006..0.006 rows=1 loops=20)
Cache Key: pl.post_id
Cache Mode: logical
Hits: 0 Misses: 20 Evictions: 0 Overflows: 0 Memory Usage: 4kB
Buffers: shared hit=60
-> Index Scan using posts_pkey on posts p (cost=0.29..2.66 rows=1 width=92) (actual time=0.005..0.005 rows=1 loops=20)
Index Cond: (id = pl.post_id)
Buffers: shared hit=60
-> Index Scan using users_pkey on users u (cost=0.29..0.33 rows=1 width=23) (actual time=0.002..0.002 rows=1 loops=20)
Index Cond: (id = p.owned_by)
Buffers: shared hit=60
-> Memoize (cost=0.30..0.39 rows=1 width=16) (actual time=0.001..0.001 rows=0 loops=20)
Cache Key: p.reply_to
Cache Mode: logical
Hits: 18 Misses: 2 Evictions: 0 Overflows: 0 Memory Usage: 1kB
Buffers: shared hit=3
-> Index Scan using posts_pkey on posts pp (cost=0.29..0.38 rows=1 width=16) (actual time=0.007..0.007 rows=0 loops=2)
Index Cond: (id = p.reply_to)
Buffers: shared hit=3
-> Index Scan using users_pkey on users pu (cost=0.29..0.33 rows=1 width=17) (actual time=0.001..0.001 rows=0 loops=20)
Index Cond: (id = pp.owned_by)
Buffers: shared hit=6
-> Append (cost=0.15..1.36 rows=8 width=16) (actual time=0.010..0.010 rows=1 loops=20)
Buffers: shared hit=40
-> Index Scan using post_counts_p0_pkey on post_counts_p0 pc_1 (cost=0.15..0.17 rows=1 width=16) (actual time=0.019..0.019 rows=1 loops=1)
Index Cond: (post_id = p.id)
Buffers: shared hit=2
-> Index Scan using post_counts_p1_pkey on post_counts_p1 pc_2 (cost=0.15..0.17 rows=1 width=16) (actual time=0.005..0.005 rows=1 loops=4)
Index Cond: (post_id = p.id)
Buffers: shared hit=8
-> Index Scan using post_counts_p2_pkey on post_counts_p2 pc_3 (cost=0.15..0.17 rows=1 width=16) (actual time=0.005..0.005 rows=1 loops=4)
Index Cond: (post_id = p.id)
Buffers: shared hit=8
-> Index Scan using post_counts_p3_pkey on post_counts_p3 pc_4 (cost=0.15..0.17 rows=1 width=16) (actual time=0.014..0.014 rows=1 loops=2)
Index Cond: (post_id = p.id)
Buffers: shared hit=4
-> Index Scan using post_counts_p4_pkey on post_counts_p4 pc_5 (cost=0.15..0.17 rows=1 width=16) (actual time=0.010..0.010 rows=1 loops=3)
Index Cond: (post_id = p.id)
Buffers: shared hit=6
-> Index Scan using post_counts_p5_pkey on post_counts_p5 pc_6 (cost=0.15..0.17 rows=1 width=16) (actual time=0.011..0.011 rows=1 loops=2)
Index Cond: (post_id = p.id)
Buffers: shared hit=4
-> Index Scan using post_counts_p6_pkey on post_counts_p6 pc_7 (cost=0.15..0.17 rows=1 width=16) (actual time=0.010..0.010 rows=1 loops=2)
Index Cond: (post_id = p.id)
Buffers: shared hit=4
-> Index Scan using post_counts_p7_pkey on post_counts_p7 pc_8 (cost=0.15..0.17 rows=1 width=16) (actual time=0.005..0.005 rows=1 loops=2)
Index Cond: (post_id = p.id)
Buffers: shared hit=4
SubPlan 1
-> Index Only Scan using post_tags_pkey on post_tags pt (cost=0.42..4.47 rows=3 width=8) (actual time=0.017..0.018 rows=3 loops=20)
Index Cond: (post_id = p.id)
Heap Fetches: 0
Buffers: shared hit=61
Planning:
Buffers: shared hit=116
Planning Time: 5.016 ms
Execution Time: 1.312 ms実測では、idx_post_likes_liked_by_created_atを逆方向に走査し、liked_byをIndex Condへ入れて先頭20件で停止した。created_at DESCのための追加Sortはない。得られた20個の投稿IDについてposts_pkeyとusers_pkeyを引き、カウンタとタグも各投稿IDに対する索引検索で取得している。参照バッファは233ページ、実行時間は1.312msだった。ユーザの全イイネや投稿全体を走査する処理はなく、SNSの「自分がイイネした最新投稿を定数件表示する」という要件どおりである。
listUsers
usersテーブルを操作するusersServiceという実装にも各種メソッドがあって、それぞれクエリを発行している。どれも軽い処理だが、ユーザの一覧を出すlistUsersだけは、注意を要する。例えば、ユーザのニックネームの前方一致条件で絞り込みを行いつつ、フォロイーもしくはフォロワーを優先して表示するsocial順のクエリは以下のものだ。
SELECT
  u.id, u.updated_at, u.snippet, u.nickname, u.avatar,
  u.ai_model, u.is_admin, u.is_frozen, u.block_strangers,
  id_to_timestamp(u.id) AS created_at,
  COALESCE(uc.follower_count, 0) AS count_followers,
  COALESCE(uc.followee_count, 0) AS count_followees,
  COALESCE(uc.post_count, 0) AS count_posts
FROM users u
LEFT JOIN user_counts uc ON uc.user_id = u.id
LEFT JOIN user_follows f1 ON
  f1.follower_id = 1853070350746583040 AND f1.followee_id = u.id
LEFT JOIN user_follows f2 ON
  f2.follower_id = u.id AND f2.followee_id = 1853070350746583040
WHERE LOWER(u.nickname) LIKE 'user00%'
ORDER BY
  (u.id = 1853070350746583040) DESC,
  (f1.follower_id IS NOT NULL) DESC,
  (f2.follower_id IS NOT NULL) DESC,
  u.id ASC OFFSET 0 LIMIT 20;
emailはuser_secretsテーブルにあり、一般のユーザ一覧では返さない。現在の一覧ではuser_countsをJOINして、フォロワー数、フォロイー数、投稿数も返す。focusUserIdが指定された場合には、上記の一覧を取得した後、返却対象IDだけに限定したクエリで、フォロー関係と双方向のブロック関係をまとめて調べて結果へ加える。
LIKE演算子による前方一致は、LOWER(nickname) text_pattern_opsのインデックスを使って絞り込める。絞り込んだ上で最後にsocial順で順位付けするため、ヒット件数が少なければ高速に動く。検索文字列が短くヒット件数が多い場合には、その全候補をスコアリングしてソートする必要があるため、処理量が増える。
現行のクエリを確認するには、以下を実行する。
EXPLAIN (ANALYZE, BUFFERS)
SELECT
  u.id, u.updated_at, u.snippet, u.nickname, u.avatar,
  u.ai_model, u.is_admin, u.is_frozen, u.block_strangers,
  id_to_timestamp(u.id) AS created_at,
  COALESCE(uc.follower_count, 0) AS count_followers,
  COALESCE(uc.followee_count, 0) AS count_followees,
  COALESCE(uc.post_count, 0) AS count_posts
FROM users u
LEFT JOIN user_counts uc ON uc.user_id = u.id
LEFT JOIN user_follows f1 ON
  f1.follower_id = 1853070350746583040 AND f1.followee_id = u.id
LEFT JOIN user_follows f2 ON
  f2.follower_id = u.id AND f2.followee_id = 1853070350746583040
WHERE LOWER(u.nickname) LIKE 'user00%'
ORDER BY
  (u.id = 1853070350746583040) DESC,
  (f1.follower_id IS NOT NULL) DESC,
  (f2.follower_id IS NOT NULL) DESC,
  u.id ASC OFFSET 0 LIMIT 20;
 Limit  (cost=4850.02..4855.32 rows=20 width=321) (actual time=15.929..15.967 rows=20 loops=1)
   Buffers: shared hit=492 read=28
   ->  Result  (cost=4850.02..5091.17 rows=910 width=321) (actual time=15.926..15.962 rows=20 loops=1)
         Buffers: shared hit=492 read=28
         ->  Sort  (cost=4850.02..4852.29 rows=910 width=313) (actual time=15.726..15.735 rows=20 loops=1)
               Sort Key: ((u.id = '1853070350746583040'::bigint)) DESC, ((f1.follower_id IS NOT NULL)) DESC, ((f2.follower_id IS NOT NULL)) DESC, u.id
               Sort Method: top-N heapsort  Memory: 27kB
               Buffers: shared hit=492 read=28
               ->  Hash Right Join  (cost=2044.86..4825.80 rows=910 width=313) (actual time=11.209..15.216 rows=1000 loops=1)
                     Hash Cond: (f2.follower_id = u.id)
                     Buffers: shared hit=484 read=28
                     ->  Bitmap Heap Scan on user_follows f2  (cost=576.90..3275.82 rows=19674 width=8) (actual time=1.078..2.971 rows=20000 loops=1)
                           Recheck Cond: (followee_id = '1853070350746583040'::bigint)
                           Heap Blocks: exact=129
                           Buffers: shared hit=208
                           ->  Bitmap Index Scan on idx_user_follows_followee_created_at  (cost=0.00..571.98 rows=19674 width=0) (actual time=1.048..1.049 rows=20000 loops=1)
                                 Index Cond: (followee_id = '1853070350746583040'::bigint)
                                 Buffers: shared hit=79
                     ->  Hash  (cost=1456.59..1456.59 rows=910 width=318) (actual time=10.109..10.114 rows=1000 loops=1)
                           Buckets: 1024  Batches: 1  Memory Usage: 143kB
                           Buffers: shared hit=276 read=28
                           ->  Hash Right Join  (cost=1235.62..1456.59 rows=910 width=318) (actual time=7.965..9.808 rows=1000 loops=1)
                                 Hash Cond: (f1.followee_id = u.id)
                                 Buffers: shared hit=276 read=28
                                 ->  Index Only Scan using user_follows_pkey on user_follows f1  (cost=0.42..200.90 rows=5056 width=16) (actual time=0.134..1.101 rows=5000 loops=1)
                                       Index Cond: (follower_id = '1853070350746583040'::bigint)
                                       Heap Fetches: 0
                                       Buffers: shared hit=1 read=22
                                 ->  Hash  (cost=1223.83..1223.83 rows=910 width=310) (actual time=7.812..7.816 rows=1000 loops=1)
                                       Buckets: 1024  Batches: 1  Memory Usage: 135kB
                                       Buffers: shared hit=275 read=6
                                       ->  Hash Right Join  (cost=588.01..1223.83 rows=910 width=310) (actual time=1.317..7.550 rows=1000 loops=1)
                                             Hash Cond: (uc.user_id = u.id)
                                             Buffers: shared hit=275 read=6
                                             ->  Seq Scan on user_counts uc  (cost=0.00..557.04 rows=30004 width=20) (actual time=0.007..2.842 rows=30004 loops=1)
                                                   Buffers: shared hit=257
                                             ->  Hash  (cost=576.64..576.64 rows=910 width=298) (actual time=1.284..1.285 rows=1000 loops=1)
                                                   Buckets: 1024  Batches: 1  Memory Usage: 122kB
                                                   Buffers: shared hit=18 read=6
                                                   ->  Bitmap Heap Scan on users u  (cost=29.44..576.64 rows=910 width=298) (actual time=0.375..0.973 rows=1000 loops=1)
                                                         Filter: (lower((nickname)::text) ~~ 'user00%'::text)
                                                         Heap Blocks: exact=18
                                                         Buffers: shared hit=18 read=6
                                                         ->  Bitmap Index Scan on idx_users_nickname_id  (cost=0.00..29.21 rows=892 width=0) (actual time=0.234..0.234 rows=1000 loops=1)
                                                               Index Cond: ((lower((nickname)::text) ~>=~ 'user00'::text) AND (lower((nickname)::text) ~<~ 'user01'::text))
                                                               Buffers: shared read=6
 Planning:
   Buffers: shared hit=427 read=10
 Planning Time: 4.358 ms
Execution Time: 16.127 ms実測では、idx_users_nickname_idからニックネーム前方一致の1000人をBitmap Heap Scanで取得し、測定用ユーザのフォロイー5000件とフォロワー20000件をそれぞれ索引から読み、Hash Joinでsocial順の判定材料を付加した。その1000候補をtop-N heapsortで並べ、先頭20件だけを返している。is_frozenの追加は返却行の幅を増やしただけで、検索条件や走査方向には影響していない。user_countsは30004件をSeq ScanしてHash Joinしているが、これは現行SQLが件数情報をLIMIT前に結合する形であるためで、今回の列追加によるデグレではない。参照バッファは520ページ、実行時間は16.127msであり、広い前方一致の候補数と対象ユーザのフォロー関係数に応じて処理する、想定どおりの計画である。
なお、LIKE演算子による前方一致検索を効率的に動かすには、DBのコレーションとインデックスの演算子クラスに注意する必要がある。現在はnicknameのインデックスをLOWER(nickname) text_pattern_opsとして小文字に正規化したものにしている。小文字に正規化した式インデックスを働かせるには、クエリ側の条件もLOWER(nickname)と同じ式にする必要がある。
両者の差を確認する際にORDER BY id LIMIT 3をつけると、PostgreSQLがusers_pkeyを先頭から読んで3件を見つけるだけで終わり、比較したいニックネーム索引の効果を測れない。そこで、該当件数を全て数える以下の2クエリを比較する。
SET jit = off;

EXPLAIN (ANALYZE, BUFFERS)
SELECT count(*)
FROM users
WHERE LOWER(nickname) LIKE 'user00%';
 Aggregate  (cost=578.91..578.92 rows=1 width=8) (actual time=0.983..0.984 rows=1 loops=1)
   Buffers: shared hit=24
   ->  Bitmap Heap Scan on users  (cost=29.44..576.64 rows=910 width=0) (actual time=0.164..0.892 rows=1000 loops=1)
         Filter: (lower((nickname)::text) ~~ 'user00%'::text)
         Heap Blocks: exact=18
         Buffers: shared hit=24
         ->  Bitmap Index Scan on idx_users_nickname_id  (cost=0.00..29.21 rows=892 width=0) (actual time=0.129..0.129 rows=1000 loops=1)
               Index Cond: ((lower((nickname)::text) ~>=~ 'user00'::text) AND (lower((nickname)::text) ~<~ 'user01'::text))
               Buffers: shared hit=6
 Planning:
   Buffers: shared hit=3
 Planning Time: 0.326 ms
 Execution Time: 1.036 ms
EXPLAIN (ANALYZE, BUFFERS) SELECT count(*) FROM users WHERE nickname LIKE 'user00%';
 Aggregate  (cost=895.45..895.46 rows=1 width=8) (actual time=9.200..9.201 rows=1 loops=1)
   Buffers: shared hit=518
   ->  Seq Scan on users  (cost=0.00..893.17 rows=910 width=0) (actual time=0.020..9.113 rows=1000 loops=1)
         Filter: ((nickname)::text ~~ 'user00%'::text)
         Rows Removed by Filter: 29014
         Buffers: shared hit=518
 Planning Time: 0.203 ms
Execution Time: 9.257 ms実測では、LOWER(nickname)版はidx_users_nickname_idから1000件を取得し、24バッファ、1.036msで終了した。式を一致させない版はusers全体をSequential Scanし、29014件をFilterで除外して518バッファ、9.257msを要した。式インデックスは検索条件側の式まで一致させて初めて意図どおりに使えることが確認できた。
listFriendsByNicknamePrefix
ユーザ名の入力補完では、自分、フォロー中のユーザ、その他のユーザの順に候補を返す。バックエンドのusersService.listFriendsByNicknamePrefixメソッドは、ページングに必要な件数をK=offset+limitとして、自分とフォロイーをpreferredへ集め、不足分だけをothersから補う。
フォロイーについては、ニックネームに一致する全ユーザからフォロー関係を確認するのではなく、user_followsからフォロイーを列挙し、各followee_idについてusersの主キーを引く。具体例は以下のクエリである。
WITH
self AS (
  SELECT 0 AS prio, u.id, lower(u.nickname) AS nkey
  FROM users u
  WHERE u.id = 1853070350746583040
    AND lower(u.nickname) LIKE 'user00%'
),
followees AS (
  SELECT 1 AS prio, fu.id, fu.nkey
  FROM user_follows f
  JOIN LATERAL (
    SELECT u.id, lower(u.nickname) AS nkey
    FROM users u
    WHERE u.id = f.followee_id
      AND u.id <> 1853070350746583040
      AND lower(u.nickname) LIKE 'user00%'
    LIMIT 1
  ) AS fu ON TRUE
  WHERE f.follower_id = 1853070350746583040
  ORDER BY fu.nkey USING ~<~, fu.id
  LIMIT 20
),
preferred AS MATERIALIZED (
  SELECT * FROM self
  UNION ALL
  SELECT * FROM followees
),
others AS (
  SELECT 3 AS prio, u.id, lower(u.nickname) AS nkey
  FROM users u
  WHERE u.id <> 1853070350746583040
    AND lower(u.nickname) LIKE 'user00%'
    AND NOT EXISTS (
      SELECT 1
      FROM user_follows f
      WHERE f.follower_id = 1853070350746583040
        AND f.followee_id = u.id
    )
  ORDER BY lower(u.nickname) USING ~<~, u.id
  LIMIT (
    SELECT GREATEST(0, 20 - COUNT(*))
    FROM preferred
  )
),
candidates AS (
  SELECT * FROM preferred
  UNION ALL
  SELECT * FROM others
),
page AS (
  SELECT id, prio, nkey
  FROM candidates
  ORDER BY prio, nkey USING ~<~, id
  OFFSET 0
  LIMIT 20
)
SELECT
  u.id, u.updated_at, u.snippet, u.nickname, u.avatar,
  u.ai_model, u.is_admin, u.is_frozen, u.block_strangers,
  id_to_timestamp(u.id) AS created_at,
  COALESCE(uc.follower_count, 0) AS count_followers,
  COALESCE(uc.followee_count, 0) AS count_followees,
  COALESCE(uc.post_count, 0) AS count_posts
FROM page p
JOIN users u ON u.id = p.id
LEFT JOIN user_counts uc ON uc.user_id = u.id
ORDER BY p.prio, p.nkey USING ~<~, u.id;
以前のfolloweesはuser_followsとusersの通常JOINだったため、プランナはフォロイー側からF人を調べる計画だけでなく、ニックネーム索引側から一致ユーザを読み、各候補のフォロー関係を確認する計画も選べた。後者は一致候補数をMとすると最悪O(M・log(F))で、MがUに近い場合には意図したO(F・log(U))にならない。LATERAL副問い合わせでfollowee_idごとの主キー検索を明示したのは、この結合方向を固定するためである。
自分の取得はusersの主キーでO(log(U))である。フォロイー数をFとすると、user_followsからF件を列挙し、その各々についてusersの主キーを引くので、followeesの支配項はO(F・log(U))である。ニックネーム前方一致の判定は主キーで取得した各フォロイー行に対して行う。Fに比例する処理は残るが、ニックネームに一致する全ユーザ数からフォロイーを探す方向にはしない。
preferredだけでK件に達しなかった場合に限り、othersを実行する。idx_users_nickname_idはLOWER(nickname) text_pattern_ops, idの複合インデックスである。ORDER BY lower(nickname) USING ~<~, u.idと書くことで、そのインデックス順に候補を読み、必要件数が揃った時点で停止できる。候補が自分またはフォロイーなら除外するため、実際に確認する候補数は検索語の選択度とフォロー関係の分布にも依存する。
フォロイー5000人のuser00000で実行計画を確認するには、上記のクエリへEXPLAINをつける。
SET jit = off;

EXPLAIN (ANALYZE, BUFFERS)
WITH
self AS (
  SELECT 0 AS prio, u.id, lower(u.nickname) AS nkey
  FROM users u
  WHERE u.id = 1853070350746583040
    AND lower(u.nickname) LIKE 'user00%'
),
followees AS (
  SELECT 1 AS prio, fu.id, fu.nkey
  FROM user_follows f
  JOIN LATERAL (
    SELECT u.id, lower(u.nickname) AS nkey
    FROM users u
    WHERE u.id = f.followee_id
      AND u.id <> 1853070350746583040
      AND lower(u.nickname) LIKE 'user00%'
    LIMIT 1
  ) AS fu ON TRUE
  WHERE f.follower_id = 1853070350746583040
  ORDER BY fu.nkey USING ~<~, fu.id
  LIMIT 20
),
preferred AS MATERIALIZED (
  SELECT * FROM self
  UNION ALL
  SELECT * FROM followees
),
others AS (
  SELECT 3 AS prio, u.id, lower(u.nickname) AS nkey
  FROM users u
  WHERE u.id <> 1853070350746583040
    AND lower(u.nickname) LIKE 'user00%'
    AND NOT EXISTS (
      SELECT 1
      FROM user_follows f
      WHERE f.follower_id = 1853070350746583040
        AND f.followee_id = u.id
    )
  ORDER BY lower(u.nickname) USING ~<~, u.id
  LIMIT (
    SELECT GREATEST(0, 20 - COUNT(*))
    FROM preferred
  )
),
candidates AS (
  SELECT * FROM preferred
  UNION ALL
  SELECT * FROM others
),
page AS (
  SELECT id, prio, nkey
  FROM candidates
  ORDER BY prio, nkey USING ~<~, id
  OFFSET 0
  LIMIT 20
)
SELECT
  u.id, u.updated_at, u.snippet, u.nickname, u.avatar,
  u.ai_model, u.is_admin, u.is_frozen, u.block_strangers,
  id_to_timestamp(u.id) AS created_at,
  COALESCE(uc.follower_count, 0) AS count_followers,
  COALESCE(uc.followee_count, 0) AS count_followees,
  COALESCE(uc.post_count, 0) AS count_posts
FROM page p
JOIN users u ON u.id = p.id
LEFT JOIN user_counts uc ON uc.user_id = u.id
ORDER BY p.prio, p.nkey USING ~<~, u.id;
Nested Loop Left Join (cost=38633.27..38803.05 rows=20 width=354) (actual time=7.114..7.162 rows=20 loops=1)
Buffers: shared hit=15152
CTE preferred
-> Append (cost=0.29..38088.24 rows=21 width=44) (actual time=0.022..7.043 rows=21 loops=1)
Buffers: shared hit=15026
-> Index Scan using users_pkey on users u_2 (cost=0.29..8.31 rows=1 width=44) (actual time=0.022..0.022 rows=1 loops=1)
Index Cond: (id = '1853070350746583040'::bigint)
Filter: (lower((nickname)::text) ~~ 'user00%'::text)
Buffers: shared hit=3
-> Limit (cost=38079.77..38079.82 rows=20 width=44) (actual time=7.016..7.019 rows=20 loops=1)
Buffers: shared hit=15023
-> Sort (cost=38079.77..38092.41 rows=5056 width=44) (actual time=7.016..7.017 rows=20 loops=1)
Sort Key: (lower((u_3.nickname)::text)) USING ~<~, u_3.id
Sort Method: top-N heapsort Memory: 26kB
Buffers: shared hit=15023
-> Nested Loop (cost=0.72..37945.23 rows=5056 width=44) (actual time=0.021..6.915 rows=999 loops=1)
Buffers: shared hit=15023
-> Index Only Scan using user_follows_pkey on user_follows f_1 (cost=0.42..200.90 rows=5056 width=8) (actual time=0.013..0.375 rows=5000 loops=1)
Index Cond: (follower_id = '1853070350746583040'::bigint)
Heap Fetches: 0
Buffers: shared hit=23
-> Memoize (cost=0.30..8.32 rows=1 width=40) (actual time=0.001..0.001 rows=0 loops=5000)
Cache Key: f_1.followee_id
Cache Mode: binary
Hits: 0 Misses: 5000 Evictions: 0 Overflows: 0 Memory Usage: 401kB
Buffers: shared hit=15000
-> Limit (cost=0.29..8.31 rows=1 width=40) (actual time=0.001..0.001 rows=0 loops=5000)
Buffers: shared hit=15000
-> Index Scan using users_pkey on users u_3 (cost=0.29..8.31 rows=1 width=40) (actual time=0.001..0.001 rows=0 loops=5000)
Index Cond: (id = f_1.followee_id)
Filter: ((id <> '1853070350746583040'::bigint) AND (lower((nickname)::text) ~~ 'user00%'::text))
Rows Removed by Filter: 1
Buffers: shared hit=15000
-> Nested Loop (cost=544.74..702.81 rows=20 width=334) (actual time=7.078..7.097 rows=20 loops=1)
Buffers: shared hit=15092
-> Limit (cost=544.46..544.51 rows=20 width=44) (actual time=7.074..7.077 rows=20 loops=1)
Buffers: shared hit=15032
-> Sort (cost=544.46..544.70 rows=97 width=44) (actual time=7.073..7.075 rows=20 loops=1)
Sort Key: preferred.prio, preferred.nkey USING ~<~, preferred.id
Sort Method: quicksort Memory: 26kB
Buffers: shared hit=15032
-> Append (cost=0.00..541.88 rows=97 width=44) (actual time=0.026..7.057 rows=21 loops=1)
Buffers: shared hit=15026
-> CTE Scan on preferred (cost=0.00..0.42 rows=21 width=44) (actual time=0.026..7.048 rows=21 loops=1)
Buffers: shared hit=15026
-> Subquery Scan on others (cost=1.20..540.97 rows=76 width=44) (actual time=0.006..0.006 rows=0 loops=1)
-> Limit (cost=1.20..540.21 rows=76 width=44) (actual time=0.005..0.006 rows=0 loops=1)
InitPlan 2 (returns $2)
-> Aggregate (cost=0.47..0.49 rows=1 width=8) (actual time=0.004..0.005 rows=1 loops=1)
-> CTE Scan on preferred preferred_1 (cost=0.00..0.42 rows=21 width=0) (actual time=0.000..0.001 rows=21 loops=1)
-> Nested Loop Anti Join (cost=0.71..5362.47 rows=756 width=44) (never executed)
-> Index Scan using idx_users_nickname_id on users u_1 (cost=0.29..1964.82 rows=909 width=17) (never executed)
Index Cond: ((lower((nickname)::text) ~>=~ 'user00'::text) AND (lower((nickname)::text) ~<~ 'user01'::text))
Filter: ((id <> '1853070350746583040'::bigint) AND (lower((nickname)::text) ~~ 'user00%'::text))
-> Index Only Scan using user_follows_pkey on user_follows f (cost=0.42..3.73 rows=1 width=8) (never executed)
Index Cond: ((follower_id = '1853070350746583040'::bigint) AND (followee_id = u_1.id))
Heap Fetches: 0
-> Index Scan using users_pkey on users u (cost=0.29..7.90 rows=1 width=298) (actual time=0.001..0.001 rows=1 loops=20)
Index Cond: (id = preferred.id)
Buffers: shared hit=60
-> Index Scan using user_counts_pkey on user_counts uc (cost=0.29..0.35 rows=1 width=20) (actual time=0.001..0.001 rows=1 loops=20)
Index Cond: (user_id = u.id)
Buffers: shared hit=60
Planning:
Buffers: shared hit=40
Planning Time: 0.790 ms
Execution Time: 7.261 ms実測では、user_follows_pkeyからフォロイー5000件をIndex Only Scanし、その各followee_idについてusers_pkeyを5000回引いた。ニックネームに一致したフォロイーは999人であり、そこからtop-N heapsortで20人を選んでいる。自分1人とフォロイー20人でpreferredが21件になったため、others側のidx_users_nickname_idとフォロー確認はnever executedとなった。最後に20件だけをusers_pkeyとuser_counts_pkeyで取得し、参照バッファは15152ページ、実行時間は7.261msだった。is_frozenの追加は返却列だけであり、ニックネームに一致する全ユーザを起点にせず、フォロイーF人を起点に各ユーザを主キーで調べる、意図したO(F・log(U))の走査方向が維持されている。
したがって、ニックネームに一致する全ユーザMを起点にフォロー関係を調べるのではなく、フォロイーF人を起点に各ユーザを主キーで調べるという、意図したO(F・log(U))の走査方向が実際に維持されている。通常JOIN案はこのデータでは速くなる可能性があっても、支配項をMへ戻すため採用しない。
fetchBatch
通知を作成するワーカーがイベントログを読み出す際には、以下のようなクエリが実行される。
SELECT
  event_id, payload::json AS payload
FROM event_logs
WHERE partition_id = 0
  AND event_id > 1869468402083381248
ORDER BY event_id ASC
LIMIT 100;
主キーがpartition_idとevent_idの複合キーなので、そのインデックスを使えば効率的な実行計画になるはずだ。イベントログの件数をEとすると、探索開始位置を求める計算量はO(log(E))で、そこから最大100件を読む部分は定数時間で済む。partition_idを完全一致で指定しているため、ORDER BYにpartition_idを重ねて書く必要はない。
このクエリには落とし穴がある。event_id単体での検索性を確保するためにevent_idへB木のユニーク制約をつけると、そちらを使ってevent_idの対象範囲をスキャンしながら該当partition_idを拾う実行計画が選ばれる可能性がある。現行スキーマではevent_id単体の検索用にハッシュインデックスを使い、バッチ取得には複合主キーを使わせる。
現行のクエリを確認するには、以下を実行する。
EXPLAIN (ANALYZE, BUFFERS)
SELECT
  event_id, payload::json AS payload
FROM event_logs
WHERE partition_id = 0
  AND event_id > 1869468402083381248
ORDER BY event_id ASC
LIMIT 100;
 Limit  (cost=0.28..12.34 rows=100 width=40) (actual time=0.039..0.112 rows=100 loops=1)
   Buffers: shared hit=7
   ->  Index Scan using event_logs_pkey on event_logs  (cost=0.28..73.00 rows=603 width=40) (actual time=0.038..0.096 rows=100 loops=1)
         Index Cond: ((partition_id = 0) AND (event_id > '1869468402083381248'::bigint))
         Buffers: shared hit=7
 Planning:
   Buffers: shared hit=70 read=1
 Planning Time: 0.451 ms
Execution Time: 0.141 ms実測ではevent_logs_pkeyが使われ、partition_id = 0とevent_id > ...の両方がIndex Condに入った。100件を取得した時点で停止し、参照バッファは7ページ、実行時間は0.141msだった。event_id単体の索引を走査してpartition_idをFilterする計画にはなっていない。
listFeed
作成された通知を読み出す際には、未読と既読について以下のクエリをそれぞれ実行する。表示件数のデフォルトはSTGY_NOTIFICATION_SHOWN_RECORDSで指定し、現在は50件である。
SELECT
  slot, term, is_read, payload::json AS payload, updated_at, created_at
FROM notifications
WHERE user_id = 1853070350746583040 AND is_read = FALSE
ORDER BY updated_at DESC
LIMIT 50;
SELECT
  slot, term, is_read, payload::json AS payload, updated_at, created_at
FROM notifications
WHERE user_id = 1853070350746583040 AND is_read = TRUE
ORDER BY updated_at DESC
LIMIT 50;
user_id、is_read、updated_atの複合インデックスを設けているので、そのインデックスを使って各リストの先頭から定数件を取得できる。未読リストと既読リストはアプリケーション側でupdated_atの降順にマージする。マージ後に再度50件へ切り詰めないので、現在のデフォルト設定では最大100件が返り得る。
検証用データでは、測定用ユーザについて未読15000件、既読15000件を作る。小さいパーティションをSequential Scanする方が安いという計画ではなく、複合インデックスが選ばれるだけの件数を用意している。現行の未読クエリを確認するには、以下を実行する。既読側はis_readをTRUEへ変えて同様に確認できる。
EXPLAIN (ANALYZE, BUFFERS)
SELECT
  slot, term, is_read, payload::json AS payload, updated_at, created_at
FROM notifications
WHERE user_id = 1853070350746583040 AND is_read = FALSE
ORDER BY updated_at DESC
LIMIT 50;
 Limit  (cost=0.29..9.10 rows=50 width=70) (actual time=0.055..0.107 rows=50 loops=1)
   Buffers: shared hit=4
   ->  Index Scan Backward using notifications_p7_user_id_is_read_updated_at_idx on notifications_p7 notifications  (cost=0.29..2643.22 rows=15000 width=70) (actual time=0.053..0.099 rows=50 loops=1)
         Index Cond: ((user_id = '1853070350746583040'::bigint) AND (is_read = false))
         Buffers: shared hit=4
 Planning:
   Buffers: shared hit=223
 Planning Time: 0.903 ms
Execution Time: 0.134 ms実測では対象パーティションnotifications_p7の複合インデックスnotifications_p7_user_id_is_read_updated_at_idxが逆方向に走査され、user_idとis_readがIndex Condに入った。別途Sortせず50件で停止し、参照バッファは4ページ、実行時間は0.134msだった。
新着通知を調べる際に、毎回同じデータを返すのは無駄だ。よって、クライアントが最後に取得した通知の最新のupdated_atをnewerThanとして渡すAPIになっていて、それより新しい未読レコードがなければサービス層はnullを返し、HTTPルートは304を返す。
SELECT 1
FROM notifications
WHERE user_id = 1853070350746583040
  AND is_read = FALSE
  AND updated_at > '2026-07-01 03:00:00+00'
LIMIT 1;
このクエリでも、user_id、is_read、updated_atを全て指定する。現行の実行計画を確認するには、以下を実行する。
EXPLAIN (ANALYZE, BUFFERS)
SELECT 1
FROM notifications
WHERE user_id = 1853070350746583040
  AND is_read = FALSE
  AND updated_at > '2026-07-01 03:00:00+00'
LIMIT 1;
 Limit  (cost=0.29..0.33 rows=1 width=4) (actual time=0.089..0.090 rows=1 loops=1)
   Buffers: shared hit=3
   ->  Index Only Scan using notifications_p7_user_id_is_read_updated_at_idx on notifications_p7 notifications  (cost=0.29..412.29 rows=9600 width=4) (actual time=0.087..0.088 rows=1 loops=1)
         Index Cond: ((user_id = '1853070350746583040'::bigint) AND (is_read = false) AND (updated_at > '2026-07-01 03:00:00+00'::timestamp with time zone))
         Heap Fetches: 0
         Buffers: shared hit=3
 Planning:
   Buffers: shared hit=5
 Planning Time: 0.271 ms
 Execution Time: 0.110 ms
実測では対象パーティションの同じ複合インデックスをIndex Only Scanし、user_id、is_read、updated_at > ...の3条件がすべてIndex Condに入った。Heap Fetchesは0で、最初の1件で停止し、参照バッファは3ページ、実行時間は0.110msだった。
現状の計算量上の懸念と対策状況
ここまでの個別クエリに加えて、コードベース全体を対象に、ユーザ数、投稿数、文書数、キュー滞留件数などの増加に対して処理量がどのように増えるかを確認した。ここで問題とするのは、単に実行時間や定数倍を短縮できるかではなく、元の用途に対して全件走査や二次時間が発生し、データ量の増加に伴って現実的に処理できなくなる経路である。
AIユーザワーカーの全件巡回
AIユーザワーカーは、凍結されていないAIユーザを一定件数ずつ取得して順番に処理する。従来は以下の形でOFFSETを増やしていた。
SELECT u.id, u.nickname, u.is_admin, u.ai_model
FROM users u
WHERE u.ai_model IS NOT NULL
  AND u.is_frozen = FALSE
ORDER BY u.id ASC
LIMIT 200 OFFSET 15000;
ai_modelが設定された全ユーザ数をA、バッチサイズをBとすると、凍結ユーザを結果から除外しても、先頭から全件を巡回する間に読み飛ばす行数は0 + B + 2B + ...となる。そのため、索引探索を除いた行走査だけでも合計O(A² / B)になり、AIユーザが増えるほど一巡の処理量が二次的に増える。
これを、直前のバッチで最後に取得したIDをカーソルとして渡すキーセットページングへ変更した。
SELECT u.id, u.nickname, u.is_admin, u.ai_model
FROM users u
WHERE u.ai_model IS NOT NULL
  AND u.is_frozen = FALSE
  AND u.id > 1853160963440578560
ORDER BY u.id ASC
LIMIT 200;
usersにはid WHERE ai_model IS NOT NULLの部分インデックスidx_users_ai_idがある。is_frozenはインデックス条件には含まれないため、凍結されたAIユーザも索引上では通過してFilterで除外されるが、各バッチはカーソル位置をB木から探して先へ進むので、全巡回で実際に通過するAIユーザ行はO(A)になる。バッチごとの探索を含めれば、全体はO(A + (A / B)・log(A))であり、従来の二次時間を避けられる。既存のOFFSETベースの一覧APIは互換性のため残し、AIユーザワーカーだけがorder=ascとafterを使う。
検証用データにはAIユーザが6000人含まれ、全員のis_frozenは偽である。従来の深いOFFSETと新しいキーセットページングを比較するには、以下を実行する。初期データにも少数のAIユーザがあるため、両クエリが返すページは厳密には数件ずれる可能性があるが、比較対象は返却内容ではなく、目的位置までに索引から通過する行数である。
SET jit = off;

EXPLAIN (ANALYZE, BUFFERS)
SELECT u.id, u.nickname, u.is_admin, u.ai_model
FROM users u
WHERE u.ai_model IS NOT NULL
  AND u.is_frozen = FALSE
ORDER BY u.id ASC
LIMIT 200 OFFSET 3000;
 Limit  (cost=136.78..145.88 rows=200 width=24) (actual time=4.213..4.561 rows=200 loops=1)
   Buffers: shared hit=287
   ->  Index Scan using idx_users_ai_id on users u  (cost=0.28..273.28 rows=6000 width=24) (actual time=0.027..4.361 rows=3200 loops=1)
         Filter: (NOT is_frozen)
         Buffers: shared hit=287
 Planning Time: 0.125 ms
 Execution Time: 4.601 ms
EXPLAIN (ANALYZE, BUFFERS) SELECT u.id, u.nickname, u.is_admin, u.ai_model FROM users u WHERE u.ai_model IS NOT NULL AND u.is_frozen = FALSE AND u.id > 1853160963440578560 ORDER BY u.id ASC LIMIT 200;
 Limit  (cost=0.28..10.12 rows=200 width=24) (actual time=0.028..0.244 rows=200 loops=1)
   Buffers: shared hit=20
   ->  Index Scan using idx_users_ai_id on users u  (cost=0.28..147.77 rows=2999 width=24) (actual time=0.026..0.224 rows=200 loops=1)
         Index Cond: (id > '1853160963440578560'::bigint)
         Filter: (NOT is_frozen)
         Buffers: shared hit=20
 Planning:
   Buffers: shared hit=3
 Planning Time: 0.214 ms
Execution Time: 0.277 ms実測では、OFFSET版はidx_users_ai_idを先頭から3200行走査して3000行を読み飛ばし、200件を返した。is_frozen = FALSEはFilterとして評価され、参照バッファは287ページ、実行時間は4.601msだった。キーセット版ではid > ...が同じ索引のIndex Condに入り、200行を取得した時点で停止している。凍結判定は同様にFilterだが、参照バッファは20ページ、実行時間は0.277msだった。検証データのAIユーザは全員非凍結なので除外行はなく、今回追加した条件によって索引利用は損なわれていない。OFFSET版がカーソル位置までの行数に比例して走査する一方、キーセット版がバッチ件数で停止するという、期待した差が確認できた。
検索索引更新キュー
検索索引更新ワーカーは、投稿用とユーザ用のループを独立して動かし、各々について次のクエリで古いタスクから定数件を取得する。
SELECT id, name_prefix, doc_id, body_text, locale, doc_timestamp
FROM search_indexing_tasks
WHERE name_prefix = 'posts'
ORDER BY id ASC
LIMIT 100;
従来はidの主キーしかなかった。そのため、別のname_prefixのタスクがID順の前方に大量に滞留すると、目的のタスクを見つけるまで最大でキュー総数Qに比例する行を調べる可能性があった。特に、対象prefixのタスクが存在しない空振りポーリングも最悪O(Q)になる。
これを避けるため、以下の複合インデックスを追加した。
CREATE INDEX idx_search_indexing_tasks_name_prefix_id
ON search_indexing_tasks(name_prefix, id);
これにより、対象prefixの先頭へO(log(Q))で移動し、そこから最大B件だけをID順に取得できる。1回の取得はO(log(Q) + B)となり、別prefixのバックログ量には比例しない。
同じデータ分布について、複合インデックスがない場合とある場合を比較するには以下を実行する。検証データには、ID順の前方にユーザ用タスク30000件、その後ろに投稿用タスク1000件が投入済みである。インデックスの削除と再作成はトランザクション内で行い、最後にROLLBACKする。
以下の2つのSQLブロックは、同じpsqlセッションで上から順に実行する。
BEGIN;

SET LOCAL jit = off;

DROP INDEX idx_search_indexing_tasks_name_prefix_id;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, name_prefix, doc_id, body_text, locale, doc_timestamp
FROM search_indexing_tasks
WHERE name_prefix = 'posts'
ORDER BY id ASC
LIMIT 100;
 Limit  (cost=0.29..133.97 rows=100 width=81) (actual time=7.074..7.130 rows=100 loops=1)
   Buffers: shared hit=517
   ->  Index Scan using search_indexing_tasks_pkey on search_indexing_tasks  (cost=0.29..1335.79 rows=999 width=81) (actual time=7.072..7.110 rows=100 loops=1)
         Filter: ((name_prefix)::text = 'posts'::text)
         Rows Removed by Filter: 29500
         Buffers: shared hit=517
 Planning:
   Buffers: shared hit=35
 Planning Time: 0.266 ms
 Execution Time: 7.170 ms
CREATE INDEX idx_search_indexing_tasks_name_prefix_id ON search_indexing_tasks(name_prefix, id); EXPLAIN (ANALYZE, BUFFERS) SELECT id, name_prefix, doc_id, body_text, locale, doc_timestamp FROM search_indexing_tasks WHERE name_prefix = 'posts' ORDER BY id ASC LIMIT 100; ROLLBACK;
 Limit  (cost=0.29..119.27 rows=100 width=81) (actual time=0.033..0.058 rows=100 loops=1)
   Buffers: shared hit=2 read=2
   ->  Index Scan using idx_search_indexing_tasks_name_prefix_id on search_indexing_tasks  (cost=0.29..1150.83 rows=967 width=81) (actual time=0.032..0.048 rows=100 loops=1)
         Index Cond: ((name_prefix)::text = 'posts'::text)
         Buffers: shared hit=2 read=2
 Planning:
   Buffers: shared hit=5 read=1
 Planning Time: 0.133 ms
Execution Time: 0.076 ms実測では、複合インデックスなしの計画は主キーをID順に走査し、29500件のusersタスクをFilterで除外してから100件を返した。参照バッファは517ページ、実行時間は7.170msだった。複合インデックスありではname_prefix = 'posts'がIndex Condに入り、別prefixのタスクを読まずに100件を取得した。参照バッファは4ページ、実行時間は0.076msで、追加のSortもない。ワーカーが並行稼働している場合には投入直後の件数から多少減るため、除外行数は必ずしも30000件ちょうどにはならない。
ユーザ一覧の順次ページング
listUsersは後方互換性のためOFFSET経路を維持しつつ、order=ascではid > after、order=descではid < afterを使えるようにした。フロントエンドのAll一覧とニックネーム条件付き一覧では、順次移動時に直前ページの末尾IDをafterとして送る。ページング部分だけの計算量を明瞭に比較するため、以下では属性のJOINを省いてユーザIDの取得部分を測定する。
検証データの新しい側から10000件を読み飛ばした位置について、OFFSET版と同じ次ページをキーセット版で取得するには以下を実行する。
SET jit = off;

EXPLAIN (ANALYZE, BUFFERS)
SELECT u.id
FROM users u
ORDER BY u.id DESC
OFFSET 10000
LIMIT 200;
 Limit  (cost=262.24..267.47 rows=200 width=8) (actual time=1.280..1.308 rows=200 loops=1)
   Buffers: shared hit=30
   ->  Index Only Scan Backward using users_pkey on users u  (cost=0.29..786.50 rows=30014 width=8) (actual time=0.029..0.904 rows=10200 loops=1)
         Heap Fetches: 0
         Buffers: shared hit=30
 Planning Time: 0.065 ms
 Execution Time: 1.334 ms
EXPLAIN (ANALYZE, BUFFERS) SELECT u.id FROM users u WHERE u.id < 1853160968684507136 ORDER BY u.id DESC LIMIT 200;
 Limit  (cost=0.29..6.07 rows=200 width=8) (actual time=0.010..0.036 rows=200 loops=1)
   Buffers: shared hit=3
   ->  Index Only Scan Backward using users_pkey on users u  (cost=0.29..578.55 rows=20015 width=8) (actual time=0.009..0.021 rows=200 loops=1)
         Index Cond: (id < '1853160968684507136'::bigint)
         Heap Fetches: 0
         Buffers: shared hit=3
 Planning Time: 0.067 ms
Execution Time: 0.052 ms実測では、OFFSET版はusers_pkeyを逆方向に10200件通過し、30バッファ、1.334msを要した。キーセット版ではid < ...がIndex Condに入り、200件だけを読み、3バッファ、0.052msで終了した。両方ともIndex Only ScanでHeap Fetchesは0だった。afterを持たないURL直打ちや既存クライアントではOFFSETへフォールバックするため、その場合の深いページングコストは後方互換性のため残る。
投稿エクスポートの全件巡回
ユーザの全投稿をエクスポートするフロントエンド処理は、従来、listPostsのOFFSETを200件ずつ増やして最後まで巡回していた。ユーザの投稿数をN、バッチサイズをBとすると、読み飛ばす行数の合計は0 + B + 2B + ...となり、全件取得はO(N² / B)になる。
listPostsへ後方互換性を保ったafterを追加し、降順では以下のように直前のバッチの最終投稿IDより小さい投稿を取得するようにした。
SELECT p.id
FROM posts p
WHERE p.owned_by = 1853070350746583040
  AND p.id < 1855878856704991232
ORDER BY p.id DESC
LIMIT 200;
postsには(owned_by, id)の複合インデックスidx_posts_owned_by_idがあるため、各バッチはカーソル位置へO(log(P))で移動して次のB件だけを読む。全巡回はO(N + (N / B)・log(P))となる。order=ascではid > after、order=descではid < afterを使い、既存クライアント向けのOFFSET経路も維持する。エクスポート処理はorder=descとafterを使うよう変更した。
ページング部分の差を明瞭にするため、以下ではuser00001が持つ20000件の投稿についてID取得部分だけを比較する。降順の先頭から10000件を読み飛ばした位置で、両クエリは同じ次ページを取得する。
SET jit = off;

EXPLAIN (ANALYZE, BUFFERS)
SELECT p.id
FROM posts p
WHERE p.owned_by = 1853160947712987136
ORDER BY p.id DESC
OFFSET 10000
LIMIT 200;
 Limit  (cost=336.17..342.89 rows=200 width=8) (actual time=2.652..2.704 rows=200 loops=1)
   Buffers: shared hit=42
   ->  Index Only Scan Backward using idx_posts_owned_by_id on posts p  (cost=0.29..667.35 rows=19860 width=8) (actual time=0.035..2.109 rows=10200 loops=1)
         Index Cond: (owned_by = '1853160947712987136'::bigint)
         Heap Fetches: 0
         Buffers: shared hit=42
 Planning Time: 0.192 ms
 Execution Time: 2.745 ms
EXPLAIN (ANALYZE, BUFFERS) SELECT p.id FROM posts p WHERE p.owned_by = 1853160947712987136 AND p.id < 1854338718761963520 ORDER BY p.id DESC LIMIT 200;
 Limit  (cost=0.29..7.72 rows=200 width=8) (actual time=0.171..0.255 rows=200 loops=1)
   Buffers: shared hit=3
   ->  Index Only Scan Backward using idx_posts_owned_by_id on posts p  (cost=0.29..181.12 rows=4866 width=8) (actual time=0.169..0.209 rows=200 loops=1)
         Index Cond: ((owned_by = '1853160947712987136'::bigint) AND (id < '1854338718761963520'::bigint))
         Heap Fetches: 0
         Buffers: shared hit=3
 Planning Time: 0.293 ms
Execution Time: 0.318 ms実測では両方ともidx_posts_owned_by_idをIndex Only Scanしたが、OFFSET版は10200件を通過し、42バッファ、2.745msを要した。キーセット版ではowned_byとid < ...の両方がIndex Condに入り、200件だけを読み、3バッファ、0.318msで終了した。Heap Fetchesはいずれも0であり、全件エクスポートでバッチ位置に比例して増えていた読み飛ばしが解消されている。
その他の懸念と現在の扱い
* 一般の一覧APIにはOFFSETページングが残る。深いページではoffsetに比例して読み飛ばすが、通常UIで何千ページも順にめくる用途は現実的ではなく、全件巡回するワーカーとは性質が異なる。listUsersとlistPostsには後方互換性を保ったままafterを追加し、order=ascではid > after、order=descではid < afterによるキーセットページングも選べるようにした。従来のOFFSETは既存クライアントのため維持する。フロントエンドのユーザ一覧では、listUsersを使うAllタブとニックネーム条件付き一覧について、次ページを取得するための直前ページ最終IDをセッション内に保存してafterを使う。訪問履歴のないページ番号をURLから直接開いた場合など、対応するカーソルがない場合は従来のOFFSETへフォールバックする。全文検索はsearchUsers、FolloweesとFollowersは別APIを使うので、このafterの対象ではない。listUsersのsocial順はIDだけではカーソルを表現できないのでafterの対象外とする。他の一般一覧APIについては現時点では保留する。
* PostgreSQLのILIKE '%...%'による本文検索と正確なCOUNT(*)は対象件数に比例する。ただし、現在はいずれも管理用途であり、公開の全文検索はTTTSへ分離しているため、現時点では保留する。
* ユーザ名の入力補完では、候補数が多いlistUsersのsocial順検索を使わず、専用のlistFriendsByNicknamePrefixを使っている。したがって、広いsocial前方一致検索は通常UIの入力補完経路には残っていない。
* listPostsByFollowees、BuildSearchSeedForUser、listFriendsByNicknamePrefixのfollowees枝は、フォロイー数Fに比例する。これは全投稿または全ユーザを走査しないための現在の設計どおりであり、支配項はそれぞれO(F・log(P))またはO(F・log(U))である。Fが極端に増えた場合には、上限、重要フォロイーの事前選択、アクティブ集合や結果のキャッシュを検討する。
* focusUserIdのイイネ済み判定では、イイネ数が少ないユーザにはliked_by側の索引、イイネ数が多いユーザには(post_id, liked_by)の複合主キーが選ばれた。後者では2条件がともにIndex Condへ入り、最大20件の候補投稿についてIndex Only Scanできることを確認した。データ分布に応じて適切な索引が選ばれているため、追加変更は行わない。
* TTTSの検索は新しい時系列シャードから順に調べ、必要件数が揃った時点で停止する。深さ上限、timeout、Redisキャッシュも設けており、最悪時に複数シャードを調べることは仕様として受け入れている。現時点では変更しない。
以上より、今回までに修正した計算量上の欠陥は、全AIユーザ巡回のOFFSET、検索索引更新キューの複合インデックス欠如、投稿エクスポートのOFFSETによる全件巡回の3件である。それ以外は、用途が限定された管理機能、通常UIだけで使う深いページング、または仕様として既知の線形性として整理し、実運用で問題が顕在化した時点で再検討する。
総評
ここまで見てきたように、通常の一覧表示で記事IDやユーザIDの候補を取得する処理では、できる限りインデックスを使って返却対象を先に絞るように、スキーマとクエリを設計している。各々のインデックスがメモリ上にキャッシュされる範囲では、高速なランダムアクセスが期待できる。ただし、本文に対するILIKE '%...%'やフォロイー全員を調べる処理など、ヒット件数やフォロイー数に比例する経路も残っている。短いニックネーム前方一致のsocial順listUsersは入力補完では使わず、専用のlistFriendsByNicknamePrefixへ置き換えている。公開の全文検索では外部検索サービスを使って、その負荷をPostgreSQLから分離している。
全体の最新投稿を一覧で使うlistPostsは、通常のIDやタグなどの条件ではインデックスから定数件を取得できる。全件エクスポートではafterとidx_posts_owned_by_idを使ってキーセットページングする。focusUserIdの返信済み判定はpostsのreply_toとowned_byの複合インデックスを使う。イイネ済み判定は、イイネ数が少ないユーザではliked_by側の索引、イイネ数が多いユーザではpost_likesの複合主キーが選ばれ、後者ではpost_idとliked_byの両方がIndex Condに入ることを確認した。自分がフォローしているユーザの最新投稿を一覧で使うlistPostsByFolloweesと、AI検索シードを作るBuildSearchSeedForUserのactive_followeesは、どちらもフォロイー別に最新投稿を1件だけ索引検索するので支配項はO(F・log(P))である。イイネした投稿の一覧で使うlistPostsLikedByUserもliked_byとcreated_atのインデックスから定数件を取得できる。listFriendsByNicknamePrefixのfollowees枝はフォロイーF人を列挙して各ユーザを主キーで調べるため、支配項はO(F・log(U))である。preferredで不足する場合のothers枝は、ニックネーム索引を順序付きで走査し、ページングに必要な件数が揃った時点で停止する。ただし、ILIKEによる本文検索は全体件数に対して同じ保証を持たない。候補数が多いsocial順のlistUsersも同じ保証を持たないが、現在のユーザ名入力補完では使用していない。
本記事で対象にした全てのEXPLAIN結果を確認した。現行クエリは、通常のSNS画面では返却対象を定数件へ先に絞ること、全件巡回ではキーセットページングを使うこと、フィードと入力補完では全投稿数・全ユーザ数ではなくフォロイー数を起点にすること、ワーカーのキュー取得では他種別のバックログを走査しないこと、という設定済みの要件を満たしている。比較のために意図的にインデックスを外したクエリや式を一致させなかったクエリだけが全件または大量候補を走査し、必要なインデックスとSQL形の効果も確認できた。したがって、現時点の要件に対して追加のSQL・インデックス変更は必要ない。
listPostsByFolloweesとlistFriendsByNicknamePrefixのfollowees枝は、いずれもフォロイー数Fに比例して索引を引く。現行実装ではフォロイー数を200人などに制限する上限は設けていない。listFriendsByNicknamePrefixのothers枝は早期終了できるが、短い検索語に多数が一致し、その中の自分やフォロイーが多い場合には、必要件数より多くの候補を確認する可能性がある。利用規模が大きくなってこれらが問題になった場合には、上限、対象フォロイーの事前選択、結果のキャッシュなどを検討する必要がある。
UXの要求仕様でフォロイー数の制限ができない場合、毎回のクエリでフォローしている全員を対象にするのではなく、「重要フォロイー」のサブセットやアクティブユーザの集合を定期的に計算してキャッシュする方法が現実的である。ただし、キャッシュがなくても正しい結果を返せるDBクエリを基礎として持つべきである。
投稿記事の本文やユーザ自己紹介の本文などのでかいデータを取得する操作も、スケーラビリティの制限要因になる。主キーに紐づいたテーブル本体のレコードを読み出すという操作は、レコード数Nに対してO(log(N))の計算量に過ぎない。しかし、データの規模が大きいと遅くなる。メモリ上のキャッシュに乗り切らないので、毎回のアクセスでストレージにアクセスするからだ。HDDであればシークタイムも加算される。読み出しのデータが大きいと、ストレージとメモリの間のデータ転送量が増えることでも遅くなる。postsとusersテーブルに本文を入れずにスニペットだけを入れるのは、この問題に対する緩和策だ。計算量を対数オーダーにするのは大前提だが、計算量に現れない最適化も地味に性能に効いてくる。
* 限界点
個々のDBサーバが、いつどのように限界を迎えるのかについて考えておくべきだ。言い換えると、要求スループットに実際のスループットが耐えられなくなる瞬間は、いつ、どのように訪れるかだ。例えば100QPSを単一の直列実行で処理するなら、平均10ms以内で1件を処理し続ける必要がある。実際のPostgreSQLは複数接続で並列に処理できるため、許容レイテンシを単純に1 / QPSでは決められない。CPU、ストレージ、ロック、接続数、クエリ同士のキャッシュ競合を含めた負荷試験で判断する必要がある。
リスト系クエリの処理が、インデックスを参照して返却対象のIDを絞り込むフェーズと、主テーブルを参照して個々のIDの属性を肉付けするフェーズから成ることは既に述べた。性能が低下する一つの契機は、頻繁に参照するインデックスとテーブルの作業集合が、PostgreSQLのshared_buffersとOSのページキャッシュに収まらなくなり、物理I/Oの割合が増えることである。shared_buffersを実メモリの25%程度から調整し始める構成は一般的だが、25%が常に最適という意味ではない。PostgreSQLのバッファとOSのページキャッシュの双方を考慮する必要があり、shared_buffersの容量だけが性能の境界になるわけでもない。
実際のテーブルやインデックスが占有しているデータサイズは、以下のクエリで確認できる。pg_relation_sizeを使うだけならpageinspect拡張は不要である。実運用を始めたら、定期的に結果を記録して増加率を確認すべきだ。
SELECT
  n.nspname AS schema,
  c.relname AS name,
  CASE c.relkind
    WHEN 'r' THEN 'table'
    WHEN 't' THEN 'toast'
    WHEN 'i' THEN 'index'
    WHEN 'm' THEN 'mview'
    ELSE c.relkind::text
  END AS type,
  pg_size_pretty(pg_relation_size(c.oid)) AS size_pretty,
  pg_relation_size(c.oid) / 8192 AS pages_8k
FROM pg_class c
JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE n.nspname NOT IN ('pg_catalog', 'information_schema')
  AND c.relkind IN ('r', 't', 'i', 'm')
ORDER BY pages_8k DESC;
投稿関係の7インデックスだけを取り出すには、以下を実行する。
SELECT
  c.relname AS name,
  pg_relation_size(c.oid) AS size,
  pg_relation_size(c.oid) / 8192 AS pages_8k
FROM pg_class c
JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE n.nspname = 'public'
  AND c.relkind = 'i'
  AND c.relname IN (
    'posts_pkey',
    'idx_posts_owned_by_id',
    'idx_posts_reply_to_id',
    'idx_posts_reply_to_owned_by',
    'idx_posts_root_id',
    'idx_posts_root_owned_by_id',
    'idx_posts_public_owned_by_published_at'
  )
ORDER BY c.relname;
name | size | pages_8k ----------------------------------------+---------+---------- idx_posts_owned_by_id | 2605056 | 318 idx_posts_public_owned_by_published_at | 4472832 | 546 idx_posts_reply_to_id | 2719744 | 332 idx_posts_reply_to_owned_by | 1245184 | 152 idx_posts_root_id | 1777664 | 217 idx_posts_root_owned_by_id | 1998848 | 244 posts_pkey | 1867776 | 228
7インデックスの合計は16687104バイトである。測定時のposts総件数81517件で割ると、このテストデータ分布では投稿1件あたり約204.7バイトになる。
仮に実メモリ16GiB、shared_buffers 4GiBとし、その半分をインデックス、その80%を投稿関係のインデックスへ使えると仮定すると、投稿インデックスへ使える容量は約1.6GiBである。1.6GiBを約204.7バイトで割る単純な線形外挿では、約839万投稿分に相当する。
これは限界値ではなく、フェルミ推定級の目安に過ぎない。7インデックスは同じ行集合を対象にしておらず、データ分布、B木ページの充填率、更新と削除による膨張、VACUUMの状態によって投稿あたりの容量は変わる。実際のアクセスは新しい投稿に偏るため、全インデックスがキャッシュに入らなくても頻繁に使うページは残りやすい。OSのページキャッシュもある。一方で、listPostsByFolloweesのように多数のユーザについて索引をランダム参照するクエリは、作業集合が広がるほど物理I/Oの影響を受けやすい。
主テーブルのデータにも別のキャッシュ境界がある。postsとusersに本文を入れず、一覧に必要なスニペットと属性だけを置くのは、主テーブルの行とページを小さく保つためである。返却対象のIDを先に定数件へ絞り、その後にだけ主テーブルを参照する設計は、計算量だけでなくキャッシュ効率の点でも重要である。大規模なSequential Scanが頻発すると、他のホットページをキャッシュから追い出す可能性もある。
作業集合がメモリとOSキャッシュに収まらなくなると、性能はストレージのランダムI/O能力に強く左右される。HDDのランダムI/Oは一般に数百IOPS程度で、SSDやNVMeは桁違いに高いが、製品、RAID、クラウドの設定、同時実行数によって大きく変わる。何百万投稿の規模でどの程度のQPSが出るかは、現行スキーマと実運用に近いストレージで測定しなければ断言できない。容量からキャッシュ飽和の目安は計算できるが、実際のスケーラビリティの限界点はベンチマークテストを経て判断すべきである。
余談
スニペットをDBに保存するということは、「どう表示するか」というフロントエンド側のプレゼンテーションの知識をバックエンド側で持つことを意味するため、責任分割の観点では気持ち悪い。本文に関数従属しているスニペットを持つのは第3正規形の違反でもある。スニペットの形式や文字数制限を変えた際にDBのレコードを入れ直さなきゃならないのも嫌だ。しかし、その気持ち悪さを飲んでもやらねばならない。
投稿記事やユーザ自己紹介の本文を分離するという手法は、いわゆる垂直分割の一種である。属性データの特性に合わせて管理方法を分割する手法とも言える。本文だけDBサーバを分けてもいいし、列指向DBに入れてもいいし、S3に入れてクライアントに直接取得させたっていい。古い記事の本文は圧縮した上でアーカイブ用のストレージに入れてもいい。post_likesやuser_followsといったテーブルを別サーバで管理するのも良いだろう。
以上のことを鑑みると、リソースのリストを取得する処理は、常に二段構えで考えるべきだ。条件に該当するIDのリストを生成する段と、そのIDに紐づけて属性を収集する段だ。RDB1台運用だとその2段が一発のクエリでできるが、それでもサブクエリを使って敢えて2段に分けて書くのも良い考えだ。以下の二つのクエリは等価で、後者の方が若干遅いかもしれないが、いずれ垂直分割する際は、後者の書き方をしておく方がバグりにくい。
SELECT id, nickname, snippet
FROM users WHERE id > 0x0000000000020001
ORDER BY id LIMIT 10;

WITH cand_ids AS (
  SELECT id FROM users
  WHERE id > 0x0000000000020001
  ORDER BY id LIMIT 10
)
SELECT u.id, u.nickname, u.snippet
FROM users AS u
JOIN cand_ids AS c ON u.id = c.id
ORDER BY c.id;
ここで使った0x0000000000020001は、10進数では131073に相当する。0x接頭辞による16進整数リテラルはPostgreSQL 16以降で利用できる。PostgreSQL 15以前で同じクエリを実行する場合は、10進数の131073と書けばよい。
なお、PostgreSQLでは、TOAST(The Oversized-Attribute Storage Technique)という機構があり、大きい可変長データを暗黙的に圧縮したり別領域へ移動したりする。SELECT対象に含めない外部TOAST値まで毎回読み出されるわけではない。しかし、主テーブルにはTOASTポインタやインライン部分が残り、短い本文は行内に格納され得る。行が太いほど1ページに入るレコード数が減るため、一覧で常用するpostsやusersを小さく保つという目的では、本文を別テーブルへ分ける効果がある。参照頻度の異なるデータを明示的に分けることで、意図せず本文を取得するクエリも避けやすい。
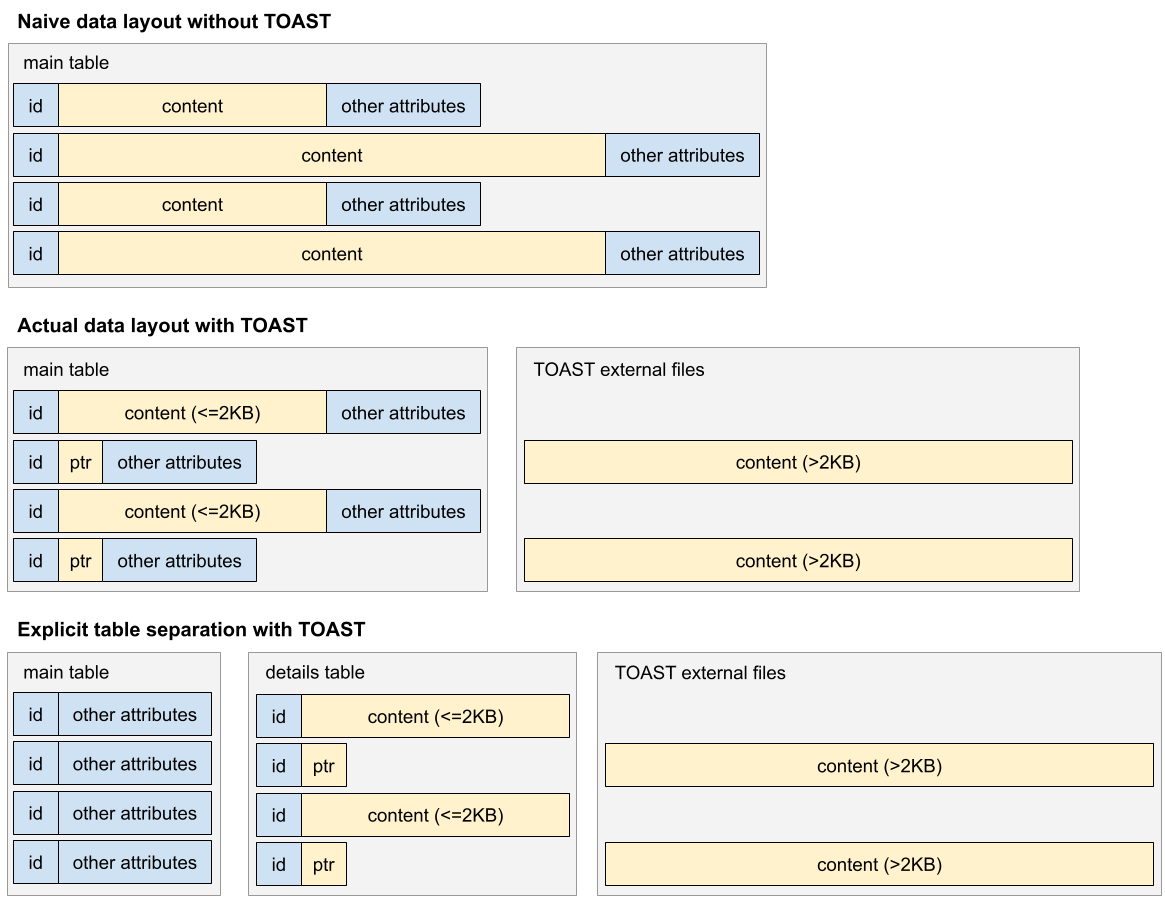
列のストレージ方式はPLAIN、MAIN、EXTERNAL、EXTENDEDで調整でき、圧縮方式も列単位で選べる。ただし、短い値を常に別領域へ追い出すという単純な指定ではなく、行サイズやTOAST閾値に基づいて格納方法が決まる。TOASTの主目的は、大きな可変長値を扱いながらヒープ行をページへ収めることである。今回は圧縮方式としてLZ4を使う設定にしており、圧縮率と展開速度のバランスを取っている。それでも、ホットな一覧用属性と大きな本文の参照頻度が明確に異なるなら、テーブルを分ける方が設計意図を表しやすい。
参照系のクエリが重い場合、マスター・スレーブのレプリケーションを導入すると簡単に負荷分散できる。DBサーバを2台立てて、更新系クエリはマスターサーバにだけ投げるようにする。その更新内容はスレーブサーバに自動的に伝搬する。参照系クエリはマスターとスレーブの双方に分散して投げると、参照系クエリの負荷はサーバあたりで半分になる。スレーブの数を増やせば参照系の負荷はもっと下げられる。マスターが死んだ時にスレーブをマスターに昇格させることで、可用性の向上にもなる。ただし、更新系クエリの負荷はこの方法では下げられない。また、マスターからスレーブに更新が伝搬するまでにタイムラグがあるので、スレーブからの結果をそのまま表示すると直前の更新操作が反映されない可能性がある。よって、更新操作直後の参照系クエリはマスターにだけ投げるとか、更新内容をキャッシュサーバに入れておいてUI上で注入するとか言った工夫が必要になる。
垂直分割やレプリケーションをしても処理しきれなくなってきたら、いよいよ水平分割をすることになる。ユーザIDを使ってパーティショニングを行うのが率直な方法だろう。ハッシュ値などで機械的に割り振っても良いが、各ユーザがどのパーティションに居るのかを管理するuser_partitionsテーブルを作るか、それに相当するKVSを運用するのが率直だ。usersテーブルを引く時はユーザIDでパーティションを特定してからそのDBサーバにアクセスし、postsテーブルを引く時は著者のユーザIDでパーティションを特定してからそのDBサーバにアクセスする。フォロー関係は、フォロー元のユーザとフォロー先のユーザのDBに二重化して持たせれば良い。垂直分割を経ているならば、もはやJOINするクエリは少なくなっていて、IDのリストを取り出してから別のDBにアクセスする作法は確立しているはずだ。あとはそのアクセス先を個々のIDに紐づいたパーティションにするだけだ。ユーザに紐づいた一連のデータをパーティション間で移動するユーティリティさえ書いておけば、運用はそんなに難しくない。
規模が大きくなると、投稿一覧の「All」のビューがほとんど意味をなさなくなってくる。見知らぬ人の投稿を全て見る奴は居ない。となると、「Pickup」とか「Topics」とかいう位置づけのビューを代わりに置くことになるだろう。最近の投稿だけを集めた小さいデータベースを作っておいて、質が高いものや個々のユーザの興味に近そうなものをバッチ処理で計算して、それを提示するのだ。
規模が大きくなると、「セレブユーザ」の存在が運用上の問題になってくる。数万人からフォローされるユーザが出てくるかもしれない。単一の投稿がものすごい勢いでイイネされたり返信されたりするかもしれない。参照系を最適化するだけでは、更新系が逼迫する問題には対処できない。その場合、セレブユーザ専用のデータ管理機構を整備すべきだろう。投稿の内容はキャッシュサーバから配信し、フォローやイイネや返信はキューに入れて非同期に処理する。通知は意味をなさないので処理を省略する。セレブユーザではなくても、突発的なバズりや炎上はあり得る。それに備えて、負荷が一定を超えたら、全体または特定ユーザを対象とする更新操作を非同期処理に切り替える機構を入れてもよいだろう。時間分散という考え方だ。非同期処理にすると更新結果がすぐに画面に反映されないという問題が起こるが、そこはキャッシュで頑張る。つまり、ユーザ毎の更新内容をキャッシュしておいて、あたかもその更新が既にDBに反映されているかのように、表示に細工をするのだ。
その他にも、キャッシュサーバでできることはたくさんある。例えば、listPostsByFolloweesの中で作っているアクティブユーザリストをキャッシュすると、それだけでDBへの負荷が激減する。各アクティブユーザの最新投稿20件の内容もキャッシュしておけば、多くの場合で、DBに全くアクセスしなくても、タイムライン表示が完結する。DB設計の話から逸脱するのでここでは詳述しないが、キャッシュ機構の設計も重要だ。ただし、キャッシュはいつだって消えるので、キャッシュがなくても満足に動くDB設計をするのが大前提だ。
ここまでいろいろ述べたが、STGYの現状の目標は、スケーラビリティを追求することではない。SNSの基本機能を率直に実装した、シンプルで典型的で教科書的なシステムを作ることだ。少なくとも開発の初期段階では、見通しがよく開発と保守がしやすいスキーマを選択すべきで、現状のスキーマはそれに叶うものになっている。時期尚早の最適化をして、人気が出る前に開発が頓挫するというのでは意味がないので、シンプルな構成から始めるというのも重要だ。
Next: STGYのメディアストレージ